AI Software Factory là gì? Nhà Máy Phần Mềm AI Toàn Diện (2026) | HNDL
Mục lục bài viết
 Được viết bởi Đặng Trí Thanh
Giám đốc Công nghệ · DNT Digital · Hướng Nghiệp Dữ Liệu
📱 Liên hệ Zalo: zalo.me/0934145100
AI Software Factory là gì? Đó là một hệ thống mà ở đó phần mềm không còn được viết chủ yếu bằng tay, mà được sản xuất bởi một dây chuyền gồm nhiều AI agent — chạy liên tục từ lúc một tín hiệu xuất hiện (một bug report, một yêu cầu khách hàng, một cảnh báo giám sát) cho đến khi bản sửa được kiểm chứng, phát hành và theo dõi trên production. Con người không biến mất; vai trò của họ chuyển từ “người viết code” sang “người thiết kế và giám sát nhà máy”.
Năm 2026, đây không còn là ý tưởng trên blog công nghệ. Factory đã công bố nền tảng “Factory 2.0 — From coding agents to software factories” (6/2026) với các khách hàng doanh nghiệp lớn như NVIDIA, Adobe, Palo Alto Networks, Adyen, Wipro; Warp chuyển hẳn từ terminal sang nền tảng điều phối software factory tên Oz; còn Claude Code, Codex, Gemini CLI thì đã trở thành “công nhân” quen thuộc trong nhiều repo. Câu hỏi đặt ra không còn là “software factory có thật không”, mà là “doanh nghiệp của tôi dựng nhà máy này thế nào để không sinh ra một núi code rác”.
Bài viết này của Hướng Nghiệp Dữ Liệu sẽ đi vào chi tiết kỹ thuật: kiến trúc 6 tầng, vòng lặp 7 bước, thang tự chủ L0–L5, cách kiểm chứng để AI không “tự tin sai”, bài toán chi phí, các rủi ro đã được ghi nhận bằng dữ liệu, và lộ trình 90 ngày để dựng một nhà máy phần mềm AI đầu tiên — kèm code mẫu chạy được.
1. AI Software Factory là gì? (Giải thích trong 60 giây)
Hãy bắt đầu bằng một so sánh đời thường. Nếu ChatGPT/Claude chat là “bạn nhắn tin hỏi AI”, và coding agent (Claude Code, Codex, Cursor) là “bạn giao một việc cho AI và nó làm trong repo của bạn”, thì AI Software Factory là “bạn xây một phân xưởng: nguyên liệu vào là công việc, thành phẩm ra là phần mềm đã kiểm định, và có dây chuyền, có trạm kiểm tra chất lượng, có đồng hồ đo năng suất”.
Ba đặc điểm phân biệt một software factory với “dùng AI cho nhanh”:
- Tính liên tục (continuous). Agent không chờ bạn gõ prompt. Nó được kích hoạt bởi tín hiệu: issue mới trên Linear/Jira, một bug từ Sentry, một tin nhắn trên Slack, một cron job rà soát dependency, một cảnh báo latency.
- Tính đầu-cuối (end-to-end). Nhà máy bao trùm toàn bộ vòng đời: triage → đặc tả → triển khai → review → kiểm chứng → phát hành → giám sát. Không chỉ “sinh code”.
- Tính tự cải thiện (self-improving). Mỗi lần chạy sinh ra dữ liệu: chỗ nào agent sai, chỗ nào reviewer phải sửa, chỗ nào production lỗi. Dữ liệu đó quay lại cải thiện spec, test, context và cả router chọn model.
Bảng dưới đây tóm tắt ba nấc thang tiến hoá:
| Tiêu chí | Chat AI | Coding agent (dùng tay) | AI Software Factory |
|---|---|---|---|
| Ai khởi động công việc | Con người gõ prompt | Con người gõ prompt | Tín hiệu: issue, alert, cron, comment |
| Phạm vi | Một đoạn code / một câu trả lời | Một task trong một repo | Toàn bộ SDLC, nhiều repo |
| Kiểm chứng | Con người tự đọc | Test thủ công hoặc bán tự động | Cổng tự động: test, SAST, eval, policy |
| Đo lường | Không có | Thời gian tiết kiệm (cảm tính) | Cost/PR, acceptance rate, revert rate, lead time |
| Học lại | Không | Yếu | Có: flywheel từ review + incident |
| Rủi ro chính | Ảo giác | Code “gần đúng”, nợ hiểu biết | Slop ở quy mô lớn, review nghẽn |
Điểm mấu chốt: giá trị không nằm ở model mạnh nhất, mà ở hệ thống bao quanh model. Cùng một model, đặt trong một harness có spec rõ ràng, có test, có sandbox, có cổng kiểm chứng — sẽ cho kết quả khác hoàn toàn so với việc copy-paste câu trả lời từ chat.
2. Từ “software factory” 1968 đến “AI software factory” 2026
Chữ “software factory” không mới. Nó xuất hiện từ cuối thập niên 1960 và bùng nổ ở Nhật thập niên 1980, khi Hitachi, NEC, Toshiba xây các trung tâm sản xuất phần mềm với quy trình chuẩn hoá, tái sử dụng component, đo năng suất theo function point. Ý tưởng cốt lõi khi đó: biến việc viết phần mềm từ nghề thủ công thành công nghiệp có tiêu chuẩn.
Ba làn sóng nối tiếp nhau:
- Làn sóng 1 (1980–2000): nhà máy phần mềm “người thật” — CMM/CMMI, quy trình, tài liệu. Thành công ở quy mô lớn nhưng chậm và đắt.
- Làn sóng 2 (2000–2022): DevOps, CI/CD, cloud. “Nhà máy” chuyển từ tài liệu sang pipeline tự động: commit → build → test → deploy. Con người vẫn viết code, máy lo phần giao hàng.
- Làn sóng 3 (2023–nay): AI agent bước vào khâu sản xuất chứ không chỉ khâu vận chuyển. Năm 2026, các từ khoá “agent-native SDLC”, “factory engineering”, “dark factory” xuất hiện dày đặc trong tài liệu của các nhà cung cấp hạ tầng.
Có một chi tiết đáng chú ý: những người làm sản phẩm độc lập với nhau lại hội tụ về cùng một ẩn dụ. Factory mô tả software factory là “hệ thống agent-native đầu-cuối, tự quan sát và tự cải thiện”; Warp mô tả nó là “vòng lặp chính của kỹ nghệ phần mềm được tự động hoá: triage, specification, implementation, review, verification, shipping, monitoring”. Hai cách mô tả khác nhau về từ ngữ nhưng giống nhau về kiến trúc: vòng lặp + tín hiệu + kiểm chứng.
Và điều quan trọng nhất mà cả hai bên đều nhấn mạnh: không ai bắt đầu bằng một nhà máy tự động hoàn toàn. Tự chủ là một quá trình chín dần, đo được, mở rộng dần theo từng loại công việc.
3. Kiến trúc một AI Software Factory: 6 tầng
Một nhà máy phần mềm AI hoạt động được cần 6 tầng. Thiếu tầng nào, hệ thống sẽ hỏng theo một kiểu rất dễ nhận ra.
| Tầng | Chức năng | Thành phần điển hình | Nếu thiếu tầng này |
|---|---|---|---|
| 1. Tín hiệu | Thu thập “nguyên liệu” công việc | Jira/Linear, Sentry, Zendesk, Slack, log, cron audit | Agent không có việc, hoặc làm việc vô nghĩa |
| 2. Triage | Phân loại, chấm điểm, định tuyến | Router + classifier model nhỏ, rule-based scoring | Agent nhảy vào việc rủi ro cao, đốt token vô ích |
| 3. Đặc tả | Biến yêu cầu mơ hồ thành spec kiểm chứng được | Spec template, ADR, acceptance criteria, scenario | Agent “đoán ý” — nguồn gốc của mọi thảm hoạ |
| 4. Thực thi | Sinh code trong môi trường cô lập | Sandbox (container/microVM), worktree, harness | Agent phá máy, rò rỉ secret, tranh chấp file |
| 5. Kiểm chứng | Chứng minh code đúng trước khi merge | Test suite, mutation test, SAST/SCA, policy-as-code, eval | “Code chạy được” ≠ “code đúng” — nợ kỹ thuật tăng nhanh |
| 6. Học lại | Biến kết quả thành tri thức | Session log, review diff, incident postmortem, eval set | Nhà máy lặp lại sai lầm cũ mãi mãi |
Dòng chảy của nhà máy có thể hình dung như sau:
Tín hiệu ──► Triage ──► Đặc tả ──► Thực thi ──► Kiểm chứng ──► Phát hành ──► Giám sát
   ▲                  (người duyệt)     (agent)      (cổng tự động)              │
   └───────────────────────────── dữ liệu quay lại ◄────────────────────────────┘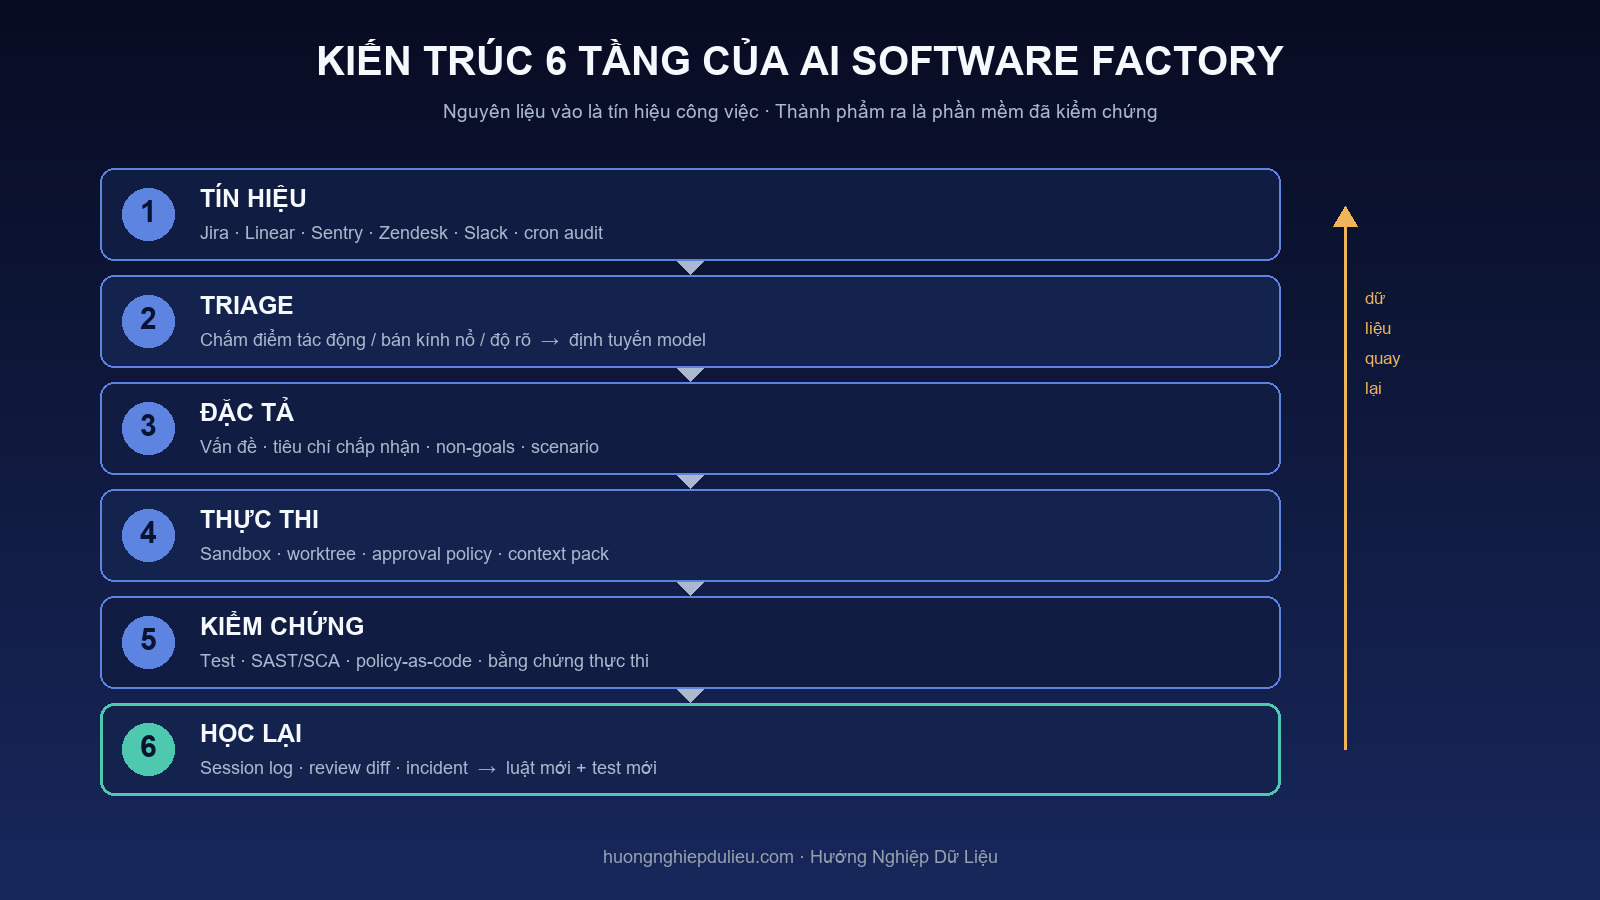
Kiến trúc 6 tầng: nguyên liệu vào là tín hiệu công việc, thành phẩm ra là phần mềm đã kiểm chứng
Chú ý hai nhánh quay ngược: nhánh thứ nhất đưa lỗi production trở lại thành tín hiệu mới (vòng lặp trong ngày). Nhánh thứ hai đưa review diff của con người trở lại thành bài học cho context và eval (vòng lặp theo tuần). Nhánh thứ hai mới là thứ khiến nhà máy giỏi dần lên — và cũng là thứ hầu hết đội ngũ bỏ qua.
3.1. Tầng tín hiệu: nguyên liệu quyết định chất lượng
Nguyên tắc: một tín hiệu tốt phải có ngữ cảnh tối thiểu — người dùng nào, môi trường nào, phiên bản nào, tái hiện được hay không. Một issue kiểu “app bị lỗi” không phải nguyên liệu; một issue kèm stack trace, request ID, ảnh chụp màn hình, tài khoản test và bước tái hiện mới là nguyên liệu.
Nhiều doanh nghiệp Việt Nam có thể bắt đầu rất đơn giản: một form nội bộ (hoặc kênh Slack) có 6 trường bắt buộc — môi trường, phiên bản, tài khoản test, bước tái hiện, kỳ vọng, thực tế. Chỉ riêng việc chuẩn hoá tín hiệu đã giảm 30–50% thời gian sửa lỗi, trước cả khi có AI.
3.2. Tầng triage: đừng để model đắt làm việc rẻ
Triage là nơi tiết kiệm tiền nhiều nhất. Công việc phân loại (bug hay feature? repo nào? rủi ro cao hay thấp? có sẵn test chưa?) nên giao cho model nhỏ, rẻ, nhanh, có thể kèm rule-based. Chỉ khi việc thực sự khó mới đẩy lên model mạnh.
Một thang điểm triage thực dụng, chấm 0–10 cho 4 tiêu chí:
- Tác động: bao nhiêu người dùng bị ảnh hưởng?
- Bán kính nổ (blast radius): chạm vào auth, thanh toán, migration dữ liệu, hay chỉ chạm UI?
- Độ rõ: có test tái hiện được không? spec đã đủ chưa?
- Độ mới: là pattern đã có trong repo hay hoàn toàn mới?
Tổng điểm quyết định mức tự chủ (xem mục 6): thấp → agent tự làm; cao → bắt buộc người viết spec và người review.
3.3. Tầng đặc tả: nơi 80% thắng thua được định đoạt
Đây là tầng bị đánh giá thấp nhất. Kinh nghiệm thực tế khi vận hành agent: chất lượng đầu ra tỉ lệ thuận với chất lượng đặc tả, chứ không tỉ lệ thuận với độ mạnh của model. Giao cho agent một yêu cầu mơ hồ rồi trách model “ngu” cũng giống như đưa cho thợ một bản vẽ nguệch ngoạc rồi trách họ làm sai.
Một đặc tả đủ tốt cho agent cần 5 phần:
- Vấn đề — hiện tượng, phạm vi ảnh hưởng, bằng chứng.
- Tiêu chí chấp nhận — viết dưới dạng kiểm chứng được, không phải cảm tính.
- Không làm gì (non-goals) — cực kỳ quan trọng, đây là “hàng rào” chống scope creep.
- Ràng buộc — hiệu năng, tương thích ngược, bảo mật, chi phí hạ tầng.
- Kịch bản kiểm thử — viết trước khi code, dưới dạng tình huống cụ thể.
3.4. Tầng thực thi: sandbox không phải là tuỳ chọn
Agent chạy được lệnh nghĩa là nó có thể rm -rf, git push --force, gửi secret ra ngoài. Nguyên tắc thiết kế: mỗi task một môi trường cô lập, quyền tối thiểu, có thời hạn.
Ba mức phổ biến:
| Mức | Công nghệ | Cô lập | Tốc độ khởi động | Phù hợp |
|---|---|---|---|---|
| Worktree + user riêng | git worktree, user OS riêng |
Yếu | Tức thì | Repo nội bộ, task nhỏ |
| Container | Docker, rootless | Trung bình | 1–5 giây | Đa số trường hợp |
| MicroVM | Firecracker, E2B, sandbox cloud | Mạnh | < 1 giây (snapshot) | Code không tin cậy, đa khách hàng |
Ngoài sandbox, cần chính sách phê duyệt (approval policy): lệnh nào agent được tự chạy, lệnh nào phải chờ người bấm duyệt. Ví dụ: đọc file, chạy test, git diff → tự do; npm install, gọi API ngoài, git push → cần duyệt; sửa file ngoài thư mục dự án, đọc .env → chặn tuyệt đối.
3.5. Tầng kiểm chứng: “chạy được” khác “đúng”
Đây là tầng quyết định một software factory là nhà máy hay là bãi rác code. Một cổng kiểm chứng tốt trả lời được 5 câu hỏi, theo thứ tự tăng dần chi phí:
- Nó có build không? (compile, lint, type-check)
- Test cũ có còn xanh không? (regression)
- Hành vi mới có đúng như spec không? (test mới, integration)
- Code có an toàn và đúng chuẩn không? (SAST, secret scan, license scan, policy-as-code)
- Nó có thực sự tốt hơn trước không? (đo lường, eval, canary)
Câu 5 là câu bị bỏ qua nhiều nhất, và cũng là câu phân biệt đội giỏi với đội trung bình.
3.6. Tầng học lại: flywheel
Mỗi khi con người phải sửa diff của agent, đó là một mẫu dữ liệu vàng: agent hiểu sai điều gì, thiếu context gì, test nào thiếu. Việc cần làm rất cụ thể:
- Sửa
AGENTS.md/CLAUDE.mdbằng đúng bài học đó (một dòng luật mới). - Thêm một test tái hiện lỗi vừa sửa (regression test).
- Thêm một ca vào eval set để lần sau đo được.
Sau 3 tháng, một đội làm đúng việc này sẽ có context pack dày — và đó chính là tài sản khiến chi phí biên giảm dần, thứ mà đối thủ không copy được bằng cách mua license.
4. Vòng lặp 7 bước — và cổng kiểm soát ở từng bước
Mổ xẻ vòng lặp chính của nhà máy, kèm câu hỏi mà mỗi bước phải trả lời:
1. Triage (thu nhận & phân loại). Tín hiệu được chuẩn hoá, gắn nhãn, chấm điểm. Cổng: nếu thiếu thông tin tái hiện → trả lại người, không đẩy vào agent.
2. Specification (đặc tả). Viết spec + kịch bản kiểm thử. Agent có thể soạn nháp spec; người duyệt. Cổng: không có tiêu chí chấp nhận kiểm chứng được → dừng.
3. Implementation (triển khai). Agent làm việc trong sandbox, commit theo từng bước nhỏ. Cổng: diff phải nằm trong phạm vi spec; vượt quá → dừng và hỏi.
4. Review. Hai tầng: AI reviewer soi ngữ nghĩa (logic sai, thiếu case biên, N+1 query, race condition), sau đó người review tập trung vào quyết định thiết kế và rủi ro. Cổng: file rủi ro cao (auth, thanh toán, migration, hạ tầng) luôn cần người.
5. Verification. Chạy toàn bộ cổng kiểm chứng. Agent phải nộp kèm bằng chứng thực thi: log test, ảnh chụp màn hình, số đo hiệu năng trước/sau. Cổng: thiếu bằng chứng = không merge.
6. Shipping. Feature flag, canary theo tỉ lệ, rollback tự động khi error rate vượt ngưỡng. Cổng: ai chịu trách nhiệm khi rollback? Phải trả lời trước.
7. Monitoring. Theo dõi error budget, latency, chi phí. Sự cố → postmortem tự động (agent soạn nháp) → một test mới + một luật mới trong context → quay lại bước 1.
Điều đáng chú ý: ba bước đầu (triage/spec) chiếm phần lớn giá trị nhưng lại ít được đầu tư nhất, vì chúng không “hào nhoáng” như xem agent viết code. Đây cũng là lý do nhiều dự án AI coding thất bại: họ tự động hoá khâu dễ nhất và bỏ qua khâu quyết định.
5. Bốn trụ cột kỹ thuật phải có
5.1. Trụ cột 1 — Spec và scenario là nguồn sự thật
Trong nhà máy, spec không phải tài liệu cho người đọc, mà là dữ liệu cho máy thi hành. Spec và test là một cặp song sinh. Viết kịch bản trước (spec-first / scenario-driven) đem lại ba lợi ích: agent có đích đến rõ ràng, người review có tiêu chuẩn khách quan, và regression được chặn tự động.
Ví dụ scenario dạng Gherkin — dễ đọc cho người, dễ parse cho máy:
Feature: Gia hạn gói dịch vụ
  Scenario: Khách hàng gia hạn trước hạn 7 ngày
    Given khách hàng có gói "Pro" hết hạn ngày 2026-11-01
    And họ bấm "Gia hạn" vào ngày 2026-10-26
    When thanh toán thành công 499.000đ
    Then hạn mới phải là 2026-12-01
    And hoá đơn phải ghi rõ "gia hạn sớm"
    And không được tạo thêm bản ghi subscription

  Scenario: Thanh toán treo quá 15 phút
    Given giao dịch ở trạng thái "pending" quá 15 phút
    When job đối soát chạy
    Then giao dịch phải chuyển sang "expired"
    And phải gửi email nhắc khách hàng
Một scenario như trên là “hợp đồng” giữa người và agent. Nó nói rõ: đừng tạo thêm subscription (non-goal ẩn), đừng quên email (case dễ bỏ sót).
5.2. Trụ cột 2 — Context pack (AGENTS.md) và môi trường mô phỏng
Agent không tự biết quy ước của bạn. Cái nó cần là một “gói ngữ cảnh” gọn, có thứ tự ưu tiên:
- Luật bất biến: ngôn ngữ, framework, cách đặt tên, cách xử lý lỗi, không dùng thư viện X.
- Bản đồ repo: thư mục nào làm gì, entrypoint ở đâu, module nào là “vùng cấm”.
- Quy trình: chạy test bằng lệnh nào, format bằng lệnh nào, commit message theo chuẩn nào.
- Bài học: danh sách ngắn các lỗi đã từng xảy ra và cách tránh.
Ví dụ một AGENTS.md tối giản nhưng hiệu quả:
## Bắt buộc
- Python 3.12, không dùng thư viện ngoài stdlib + (requests, pydantic).
- Mọi hàm public phải có type hint và docstring 1 dòng.
- Không sửa file trong `migrations/` — tạo migration mới.
- Không đọc hoặc in nội dung file `.env`.

## Trước khi báo xong
1. `ruff check .` phải sạch.
2. `pytest -q` phải xanh 100%.
3. Nộp kèm output test và `git diff --stat`.

## Bài học đã ghi nhận
- 2026-08: agent từng đổi timezone mặc định sang UTC → hỏng báo cáo ngày. Luôn dùng `Asia/Ho_Chi_Minh` cho báo cáo nghiệp vụ.
- 2026-09: `SELECT *` trên bảng 5 triệu dòng làm sập dashboard. Luôn giới hạn cột và dùng index.
Môi trường mô phỏng (“digital twin”) là trụ cột đi kèm: một bản sao thu nhỏ của hệ thống thật (DB mẫu, API giả lập, dữ liệu ẩn danh) để agent thử nghiệm mà không chạm production. Không có môi trường này, mọi kiểm chứng đều là “tin tưởng” chứ không phải “chứng minh”.
5.3. Trụ cột 3 — Cổng kiểm chứng tự động
Đây là nơi đầu tư sinh lời cao nhất. Một pipeline tối thiểu cho nhà máy:
name: factory-gate
on: [pull_request]

jobs:
  verify:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with: { python-version: "3.12" }
      - run: pip install -r requirements-dev.txt

      - name: Lint & type
        run: |
          ruff check .
          mypy src --ignore-missing-imports

      - name: Unit + integration test
        run: pytest -q --cov=src --cov-fail-under=80

      - name: Security
        run: |
          pip-audit
          bandit -r src -ll
          gitleaks detect --no-git -v

      - name: Policy (không cho phép sửa vùng cấm)
        run: python scripts/policy_check.py --base origin/main

      - name: Bằng chứng thực thi
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: proof-${{ github.event.number }}
          path: |
            test-report.xml
            coverage.xml
Hai chi tiết nhỏ nhưng quan trọng: (1) --cov-fail-under chặn kiểu “viết code mới, không viết test”; (2) policy_check.py chặn agent sửa vào vùng cấm (ví dụ migrations/, infra/, auth/) — đây là hàng rào cứng, không phụ thuộc vào việc agent có “ngoan” hay không.
5.4. Trụ cột 4 — Quan sát và đo lường
Không đo thì không quản lý được. Bộ chỉ số tối thiểu cho một software factory:
| Nhóm | Chỉ số | Ý nghĩa | Ngưỡng tham khảo |
|---|---|---|---|
| Năng suất | Lead time (issue → merge) | Tốc độ nhà máy | Giảm dần theo tháng |
| Chất lượng | Revert rate | Tỉ lệ phải rollback | < 5% |
| Chất lượng | Escape defect rate | Lỗi lọt ra production | Không tăng so với trước |
| Review | Review latency | Thời gian chờ người duyệt | Là điểm nghẽn số 1 |
| Kinh tế | Cost per merged PR | Chi phí token + hạ tầng / PR | Đo theo tuần |
| Tự chủ | % PR do agent tạo | Mức độ chín của nhà máy | Tăng 5–10%/quý |
| Sức khoẻ code | Duplication ratio | Mã trùng lặp | Không tăng |
Điểm cần cảnh giác: % PR do agent tạo không phải là mục tiêu. Tối ưu chỉ số này một cách mù quáng sẽ đẩy nhà máy về phía “làm cho có”. Chỉ số đúng để tối ưu là cost per merged PR có chất lượng giữ nguyên hoặc tốt hơn.
6. Thang tự chủ L0–L5: đừng nhảy cóc
Tự chủ là phổ, không phải công tắc. Một thang tham chiếu thực dụng:
| Mức | Tên | Agent làm gì | Người làm gì | Phù hợp |
|---|---|---|---|---|
| L0 | Thủ công | Không | Tất cả | Hệ thống rủi ro cao, chưa có test |
| L1 | Gợi ý | Sinh code trong IDE | Viết, sửa, kiểm | Bắt đầu |
| L2 | Agent có hướng dẫn | Sửa trong nhánh, chạy test | Viết spec, review 100% | Tháng đầu |
| L3 | Agent tự chủ có giám sát | Toàn bộ task nhỏ, tự tạo PR | Review theo rủi ro | Tháng 2–4 |
| L4 | Tự chủ rộng | Nhiều task song song, tự triage | Review mẫu + xử lý ngoại lệ | Tháng 5–9 |
| L5 | “Dark factory” | Vòng lặp khép kín, tự phát hành | Đặt chính sách, xử lý sự cố lạ | Hiếm, chỉ nên ở mảng rủi ro thấp |
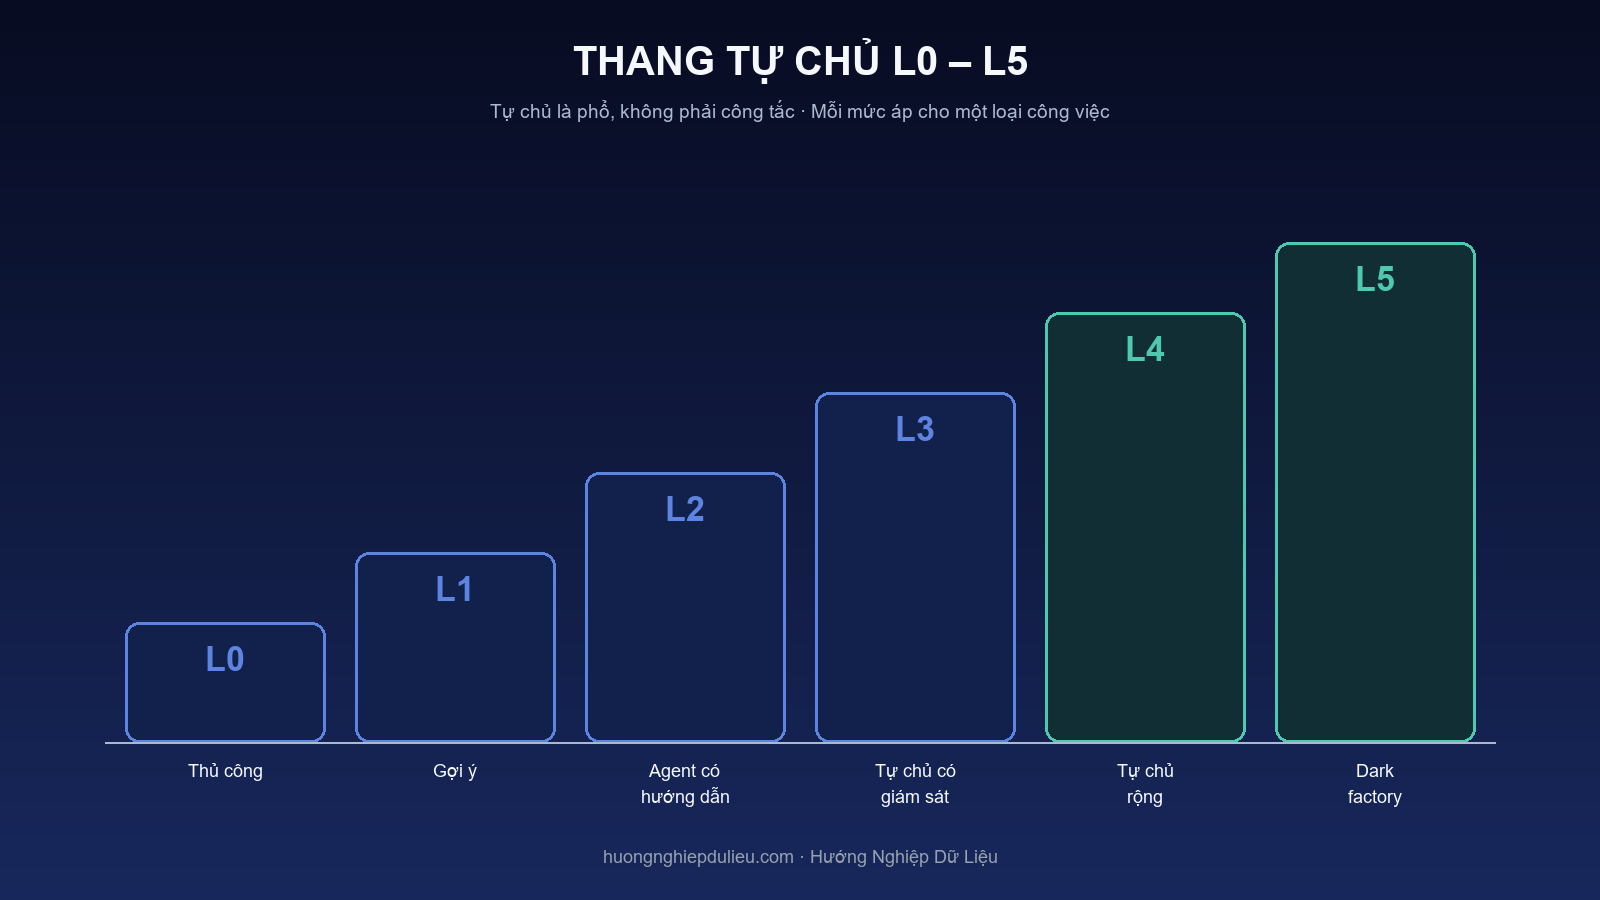
Thang tự chủ L0–L5: mỗi mức chỉ nên áp cho một loại công việc, không áp cho toàn bộ codebase
Lời khuyên quan trọng: mỗi mức chỉ nên áp dụng cho một tập công việc cụ thể, không áp cho toàn bộ codebase. Ví dụ rất thực tế: đặt L4 cho “sửa lỗi chính tả, cập nhật dependency, thêm test, sửa log message, đổi màu theo design token” — và giữ L1 cho “logic thanh toán, migration dữ liệu, hạ tầng”.
Nhà máy tốt không phải nhà máy có mức tự chủ cao nhất, mà là nhà máy biết chỗ nào nên để máy làm và chỗ nào phải có người.
7. Bản đồ công cụ năm 2026
Không có “một công cụ làm tất cả”. Một nhà máy thực tế là sự ghép nối:
| Vai trò trong nhà máy | Lựa chọn phổ biến | Ghi chú chọn nhanh |
|---|---|---|
| Harness/agent lõi | Claude Code, Codex CLI, Gemini CLI, open-source harness | Chọn theo chất lượng trên codebase của bạn, đo bằng eval riêng |
| Nền tảng factory | Factory (Droids, Missions), Warp Oz | Mạnh ở điều phối + quan sát nhiều repo |
| Agent trong IDE | Cursor, VS Code + extension agent | Tốt cho L1–L2, phản hồi nhanh |
| Agent nền/cloud | GitHub coding agent, Jules, agent cloud khác | Tốt cho task “để qua đêm” |
| Sandbox | Docker, Firecracker, E2B, sandbox cloud | Bắt buộc nếu chạy code không tin cậy |
| Điều phối & tích hợp | GitHub Actions, MCP server, webhook | MCP là cách chuẩn để nối công cụ nội bộ |
| Quan sát | Sentry, OpenTelemetry, dashboard chi phí | Không có thì mù hoàn toàn |
Hai tiêu chí chọn nền tảng mà ít người nghĩ tới, nhưng lại quyết định chi phí dài hạn:
- Độc lập model (model independence). Model tốt nhất thay đổi mỗi 3–6 tháng. Nếu nền tảng khoá bạn vào một model, bạn sẽ trả giá bằng cả tiền và chất lượng. Hãy chọn hệ thống cho phép router: model rẻ làm việc rẻ, model mạnh làm việc khó.
- Chủ quyền dữ liệu (sovereignty). Code là tài sản. Cần biết rõ: dữ liệu có được dùng để huấn luyện không, có chạy được self-host/air-gapped không, log lưu ở đâu, xoá được không.
8. Kinh tế học của nhà máy: tiền ở đâu, tiền mất ở đâu
Nhiều đội thử AI rồi kết luận “không hiệu quả” vì nhìn sai chỗ. Hãy tính theo chi phí một PR được merge, không phải theo “số dòng code sinh ra”.
Công thức thực dụng:
Cost per merged PR =
    (token vào + token ra) × giá model
  + thời gian sandbox/CI × giá hạ tầng
  + thời gian người review × lương/giờ
  + chi phí sửa lỗi lọt production (phân bổ)
  ─────────────────────────────────────────────
              số PR merge được
Đoạn Python nhỏ để tự tính, dùng được ngay:
from dataclasses import dataclass

@dataclass
class PR:
    tokens_in: int
    tokens_out: int
    gpu_minutes: float
    review_minutes: float
    rework: bool = False

GIA_IN  = 3.0 / 1_000_000     # USD / token vào
GIA_OUT = 15.0 / 1_000_000    # USD / token ra
GIA_PHUT_MAY = 0.02           # USD / phút sandbox
GIA_PHUT_NGUOI = 0.35         # USD / phút review (tham số hoá)

def chi_phi(pr: PR) -> float:
    return (
        pr.tokens_in * GIA_IN
        + pr.tokens_out * GIA_OUT
        + pr.gpu_minutes * GIA_PHUT_MAY
        + pr.review_minutes * GIA_PHUT_NGUOI
        + (0.5 if pr.rework else 0.0)   # phạt làm lại
    )

ds = [PR(180_000, 25_000, 6, 22), PR(90_000, 12_000, 3, 35, rework=True)]
for pr in ds:
    print(f"chi phi PR: {chi_phi(pr):.2f} USD")
print("trung binh:", round(sum(map(chi_phi, ds)) / len(ds), 2), "USD/PR")
Chạy thử sẽ thấy ngay điều thú vị: chi phí token thường nhỏ hơn chi phí review rất nhiều. Với ví dụ trên, token chỉ vài cent trong khi 22 phút review là ~7 USD. Kết luận thực tiễn:
- Tối ưu thời gian review (spec rõ, diff nhỏ, bằng chứng sẵn) sinh lời hơn tối ưu token.
- Đừng tiếc tiền dùng model mạnh cho task khó — nó rẻ hơn một vòng review sai.
- Ngược lại, đừng dùng model mạnh cho việc phân loại, format, đổi tên biến.
Ba đòn bẩy giảm chi phí theo thứ tự hiệu quả: (1) spec tốt hơn, (2) chia task nhỏ hơn, (3) router chọn model. Giảm giá token chỉ là đòn bẩy thứ tư.
9. Bảy rủi ro đã được ghi nhận bằng dữ liệu (và cách chặn)
Đây là phần quan trọng nhất của bài, vì hầu hết tài liệu về software factory chỉ nói về lợi ích.
1. Nghịch lý năng suất. Một thử nghiệm ngẫu nhiên có kiểm soát của METR (công bố 7/2025) trên các lập trình viên giàu kinh nghiệm làm việc trong repo quen thuộc cho thấy nhóm dùng AI chậm hơn 19%, trong khi chính họ cảm thấy nhanh hơn ~20%. Bài học: cảm giác nhanh không phải là nhanh; phải đo bằng lead time thật. Cách chặn: đo trước–sau trên cùng một loại task, đừng tin cảm tính.
2. Năng suất tăng nhưng độ ổn định giảm. Báo cáo DORA ghi nhận khi tổ chức tăng mức độ dùng AI, thông lượng giao hàng có thể giảm nhẹ (~1,5%) và độ ổn định giảm rõ hơn (~7,2%). Nghĩa là: nhiều code ra hơn, nhưng nhiều sự cố hơn. Cách chặn: cổng kiểm chứng và feature flag phải đi cùng tốc độ, không đi sau.
3. Mã trùng lặp và “copy-paste hồi sinh”. Các báo cáo của GitClear từ 2024 trở đi cho thấy tỉ lệ mã trùng lặp tăng, trong khi việc “di chuyển/tái cấu trúc code” giảm — dấu hiệu của việc sinh code mới thay vì tái sử dụng. Hậu quả là codebase phình ra, chi phí bảo trì tăng. Cách chặn: gate duplication ratio, bắt buộc agent tìm code tương tự trước khi viết mới, review tập trung vào khả năng tái sử dụng.
4. “Code gần đúng”. Khảo sát Stack Overflow 2025: phần lớn lập trình viên đã dùng AI, nhưng khoảng 46% không tin độ chính xác của câu trả lời và 66% bực bội vì code “gần đúng nhưng không đúng”. Đây là loại lỗi tệ nhất vì nó trông đúng và làm người review mất cảnh giác. Cách chặn: bắt buộc bằng chứng thực thi (log test, số đo), không chấp nhận “tôi đã kiểm tra rồi”.
5. Nợ hiểu biết (comprehension debt). Khi 40–60% code do agent viết, đội ngũ dần không còn hiểu hệ thống của mình. Sự cố production xảy ra lúc 2 giờ sáng sẽ không có ai đủ hiểu để sửa. Cách chặn: giới hạn tỉ lệ code agent/người theo module; bắt buộc agent viết “giải thích thiết kế” trong PR; luân phiên người review để tri thức phân tán; định kỳ “đọc lại code” (code walkthrough).
6. Bề mặt tấn công mới. Agent đọc file, chạy lệnh, gọi API — nghĩa là prompt injection qua nội dung file, issue, hay trang web là rủi ro thật. Cách chặn: sandbox, chặn network theo allowlist, không đưa secret vào context, quét secret trong diff, ký commit, ghi lại model + prompt version trong PR.
7. Phụ thuộc nhà cung cấp. Khi nhà máy đã chạy, đổi nền tảng rất đau. Cách chặn: giữ spec, test, context pack trong repo của bạn (không nằm trong UI của nhà cung cấp); dùng chuẩn mở (MCP, OpenTelemetry); thiết kế lớp adapter model.
Và một sai lầm không do AI: dựng nhà máy trên codebase không có test. Không có test thì không có kiểm chứng; không có kiểm chứng thì nhà máy chỉ là máy sinh rủi ro. Nếu repo của bạn test coverage thấp, việc đầu tiên không phải là mua công cụ, mà là dùng AI để viết test cho code cũ — đây là ứng dụng AI sinh lời nhanh và an toàn nhất.
10. Con người trong nhà máy: 5 vai trò mới
“Factory” không có nghĩa là hết vai trò kỹ sư. Nó có nghĩa là công việc dịch lên một tầng trừu tượng: từ viết code sang thiết kế hệ thống sinh code. Năm vai trò xuất hiện:
- Spec owner — người biến vấn đề kinh doanh thành đặc tả kiểm chứng được. Kỹ năng cốt lõi: đặt câu hỏi, viết tiêu chí, cắt phạm vi.
- Factory engineer — người xây và tinh chỉnh nhà máy: harness, sandbox, router, pipeline, context pack. Đây là vai trò “meta-engineering” — kỹ sư xây hệ thống xây sản phẩm.
- Eval owner — người duy trì bộ đánh giá: mỗi lỗi thành một ca test; mỗi quý đo lại, phát hiện hồi quy chất lượng.
- Reviewer có thẩm quyền — người quyết định cuối ở vùng rủi ro cao; không review từng dòng mà review quyết định.
- Platform/SRE — người bảo đảm rollback, quan sát, chi phí, và on-call hoạt động được khi nhà máy chạy nhanh.
Điều này giải thích vì sao các tổ chức triển khai nghiêm túc đều nói cùng một ý: kỹ sư quan trọng hơn, không kém đi — vì họ chịu trách nhiệm về hệ thống sinh ra sản phẩm, chứ không chỉ về sản phẩm.
11. Lộ trình 90 ngày dựng nhà máy đầu tiên
Đây là lộ trình thực dụng, đã tính đến việc đội ngũ Việt Nam thường nhỏ (3–15 người) và không có thời gian làm dự án phụ.
| Tuần | Việc cần làm | Sản phẩm bàn giao | Chỉ số cần đạt |
|---|---|---|---|
| 1–2 | Chọn 1 repo, 1 loại task hẹp (sửa bug nhỏ / thêm test) | Danh sách 10 task mẫu | Có baseline lead time |
| 3–4 | Viết AGENTS.md, chuẩn hoá lệnh test/lint |
Context pack v1 | Agent chạy được test cục bộ |
| 5–6 | Dựng sandbox + approval policy | Môi trường cô lập | Không còn agent chạy trên máy thật |
| 7–8 | Dựng cổng kiểm chứng (CI gate + policy check) | Pipeline factory-gate |
100% PR đi qua gate |
| 9–10 | Chạy L2: 10 task, review 100% | Báo cáo 10 task | Cost/PR, accept rate |
| 11–12 | Thêm flywheel: mỗi lỗi → 1 luật + 1 test | Context pack v2, eval set 20 ca | Số lỗi lặp lại giảm |
| 13 | Mở rộng lên L3 cho 1 loại task rủi ro thấp | Chính sách tự chủ bằng văn bản | % PR agent tạo ≥ 20% |
Ba lưu ý cho lộ trình này:
- Chọn task hẹp nhưng thật. Đừng làm demo “tạo todo app”. Hãy chọn đúng loại bug mà đội bạn gặp hàng tuần.
- Đừng bỏ tuần 11–12. Đây là tuần biến chi phí từ “tuyến tính” thành “giảm dần”. Bỏ qua nó, bạn sẽ có một nhà máy không bao giờ giỏi lên.
- Ghi chính sách bằng văn bản. “Agent được tự merge những loại nào” phải là một file trong repo, có người duyệt, có ngày hiệu lực.
12. Áp dụng cho doanh nghiệp Việt Nam: ba kịch bản cụ thể
Kịch bản 1 — Công ty outsource / làm phần mềm thuê. Nỗi đau lớn nhất là biên lợi nhuận bị bào mòn bởi việc sửa đi sửa lại và bàn giao thiếu test. Nhà máy phần mềm AI ở đây nên bắt đầu từ test + tài liệu + review: dùng agent viết test cho code cũ, sinh tài liệu API, soát lỗi bảo mật trước khi bàn giao. Giá trị không phải “code nhanh hơn” mà là giảm giờ làm lại — thứ trực tiếp ăn vào lợi nhuận.
Kịch bản 2 — Doanh nghiệp SME có phần mềm nội bộ. Đội 2–5 người, không có ban QA. Ở đây nên dựng nhà máy hẹp nhưng khép kín: một repo, một pipeline, một cổng kiểm chứng, agent xử lý các việc lặp lại (cập nhật dependency, sửa lỗi form, thêm báo cáo, đổi nội dung theo mùa). Mức tự chủ L2–L3 là đủ và an toàn.
Kịch bản 3 — Đơn vị đào tạo / sản phẩm dữ liệu (như HNDL – DNT Digital). Nhà máy dùng để sản xuất nội dung kỹ thuật có kiểm chứng: bài giảng kèm code chạy được, notebook có test, bot trading có backtest và kiểm soát rủi ro. Điểm cốt lõi giống hệt phần mềm: không có bằng chứng thực thi thì không phát hành. Một bài viết có code phải kèm output thật; một chiến lược phải kèm kết quả backtest và điều kiện thị trường.
Điểm chung của cả ba kịch bản: bắt đầu từ chỗ đau nhất, không bắt đầu từ công cụ hot nhất.
13. Câu hỏi thường gặp
AI Software Factory có thay thế lập trình viên không? Không, nhưng nó thay đổi công việc. Việc “gõ code theo yêu cầu rõ ràng” giảm mạnh; việc “làm rõ yêu cầu, thiết kế hệ thống, đánh giá rủi ro, xây hạ tầng kiểm chứng” tăng mạnh. Kỹ sư hiểu hệ thống sâu vẫn là người quan trọng nhất trong phòng khi có sự cố.
Doanh nghiệp nhỏ 3 người có dựng được không? Được, và thực ra dễ hơn doanh nghiệp lớn vì ít rào cản quy trình. Điều kiện tối thiểu: có test tự động (dù ít), có repo trên nền tảng có CI, có một người chịu trách nhiệm review. Không cần mua nền tảng đắt tiền ở giai đoạn đầu.
Chi phí thực tế bao nhiêu? Với một đội 5 người, chi phí token thường ở mức vài chục đến vài trăm USD/tháng — nhỏ so với chi phí lao động. Chi phí lớn thật sự là thời gian thiết lập (khoảng 100–200 giờ kỹ sư trong 3 tháng đầu) và thời gian review. Hãy tính ROI bằng giờ làm lại được cắt giảm, không bằng số dòng code.
Nên chọn nền tảng nào trước? Chọn theo thứ tự: (1) harness/agent bạn thấy chất lượng tốt nhất trên codebase của mình — đo bằng 10 task thật; (2) CI/CD sẵn có; (3) sandbox; (4) nền tảng điều phối nhiều repo nếu bạn có nhiều repo. Đừng bắt đầu bằng nền tảng điều phối khi còn chưa có test.
Bao lâu thì thấy kết quả? Kết quả đầu tiên (giảm thời gian sửa bug nhỏ) thường thấy trong 3–6 tuần. Kết quả ở cấp tổ chức (lead time giảm, revert rate giảm) thường cần 2–3 quý, vì phải xây cổng kiểm chứng và flywheel trước.
Làm sao biết AI đang làm hỏng codebase? Ba dấu hiệu sớm: (1) revert rate tăng; (2) số file bị sửa mỗi PR tăng mà không có lý do; (3) reviewer bắt đầu nói “tôi không hiểu đoạn này nhưng test xanh”. Dấu hiệu thứ ba là nghiêm trọng nhất — nó là nợ hiểu biết.
14. Kết luận
AI Software Factory là gì? Đó là bước tiến từ “dùng AI để viết code nhanh hơn” sang “xây một hệ thống sản xuất phần mềm có kiểm chứng”. Giá trị không nằm ở model, mà ở kiến trúc: tín hiệu rõ → đặc tả kiểm chứng được → thực thi trong sandbox → cổng kiểm chứng tự động → phát hành có kiểm soát → học lại thành context và test.
Những điểm cần nhớ:
- ✅ Nhà máy = vòng lặp liên tục, không phải một prompt dài.
- ✅ Đặc tả và test là tài sản chiến lược, không phải thủ tục.
- ✅ Sandbox + approval policy là điều kiện bắt buộc, không phải tuỳ chọn.
- ✅ Đo bằng cost per merged PR và revert rate, không bằng số dòng code.
- ✅ Đi theo thang L0 → L5, mỗi mức áp cho một loại việc cụ thể.
- ✅ Flywheel (lỗi → 1 luật + 1 test) là thứ khiến chi phí giảm dần.
- ⚠️ Rủi ro lớn nhất không phải AI viết sai, mà là đội ngũ không còn hiểu hệ thống của mình.
Nếu bạn muốn bắt đầu ngay hôm nay, hãy làm đúng một việc: chọn repo nhỏ nhất của bạn, viết AGENTS.md 20 dòng, dựng một pipeline chạy lint + test, rồi giao cho agent 3 task thật. Sau 3 task đó, bạn sẽ có dữ liệu — và dữ liệu là thứ duy nhất đáng tin trong giai đoạn này.
Còn nếu bạn muốn học bài bản từ lập trình Python, tự động hoá quy trình, đến xây hệ thống AI agent có kiểm chứng, hãy tham gia các khóa học của Hướng Nghiệp Dữ Liệu — nơi bạn không chỉ học viết code, mà học cách xây hệ thống sinh ra code đúng.
📌 Xem thêm: Lập trình Python nâng cao — Tự động hóa · Deploy ứng dụng Python lên Render · 🌐 Website Hướng Nghiệp Dữ Liệu