Đằng sau thongtinbiz.com: Một ngày đánh trận với bot và cách biến 2,1 triệu hồ sơ doanh nghiệp thành doanh thu
Mục lục bài viết
Ngày 17/11/2026, 7 giờ sáng. Tôi mở database của thongtinbiz.com và nhìn thấy một con số khiến mọi thứ phải dừng lại: 2.127.868 hồ sơ doanh nghiệp — nhưng chỉ có 88 địa chỉ email.
Hai triệu dòng dữ liệu đăng ký kinh doanh. 122.562 số điện thoại. 23.750 website. Và 88 email. Một tỷ lệ lệch đến mức vô lý: nếu bạn có website của một doanh nghiệp, khả năng cao website đó có email liên hệ — vậy mà gần như toàn bộ 23.750 website kia chưa hề được đọc.
Bài viết này kể lại trọn một ngày làm việc thật trên hệ thống đó: một bên là cuộc chiến chống bot cào dữ liệu, một bên là cuộc đi săn dữ liệu liên hệ, và cuối cùng — phần quan trọng nhất — là khung phân tích để biến đống hồ sơ thô thành doanh thu. Mọi con số trong bài đều là số thật, lấy từ log máy chủ và database, không phải con số marketing.
1. Nghịch lý của một website “có dữ liệu nhưng không có liên hệ”
Dữ liệu đăng ký kinh doanh của Việt Nam có một đặc điểm ít ai để ý: nó rất đầy đủ về pháp lý nhưng rất nghèo về liên hệ. Bạn biết mã số thuế, địa chỉ trụ sở, người đại diện pháp luật, ngành nghề, vốn điều lệ, ngày thành lập. Nhưng để bán được hàng, bạn cần đúng ba thứ mà dữ liệu gốc thường không có: số di động của người quyết định, email, và một kênh liên hệ còn sống.
Đó là lý do thongtinbiz.com được xây dựng như một lớp “làm giàu dữ liệu” (data enrichment) chứ không chỉ là một trang tra cứu. Kiến trúc hiện tại gọn đến mức dễ bị coi thường:
- ASP.NET Core Razor Pages render phía máy chủ — không SPA, không API rườm rà. Trang chi tiết doanh nghiệp trả về HTML tĩnh đầy đủ nghĩa là Googlebot và các AI crawler đọc được ngay, không cần chạy JavaScript.
- PostgreSQL chạy portable, cổng 5433, một bảng
Companieshơn 2,1 triệu dòng cùng các bảng phụ cho lịch sử thay đổi, điểm tiềm năng, đơn hàng và credit. - Cache làm nóng khi khởi động để trang chủ không phải đếm lại 2,1 triệu dòng mỗi lượt truy cập.
- Caddy làm reverse proxy, tự lo HTTPS và ghi access log JSON — chính cái log này về sau trở thành vũ khí phân tích.
Về mặt kinh doanh, mô hình cũng rõ ràng: người dùng đăng ký tài khoản, nạp credit, dùng credit để xuất file Excel theo bộ lọc (tỉnh/thành, ngành nghề, chỉ doanh nghiệp có số di động). Ngoài ra có 8 “bộ dữ liệu đóng gói sẵn” như data telesale toàn quốc, data telesale TP.HCM, data nội thất TP.HCM, data nhà hàng – ăn uống TP.HCM… Mỗi bộ hiển thị số lượng thật đang có trong database, kèm 10 hồ sơ xem trước và nút mua.
Vấn đề duy nhất: dữ liệu càng giá trị thì càng bị cào. Và đó là lúc “trận đánh” bắt đầu.
2. Trận đánh thứ nhất: ai đang đọc website của bạn?
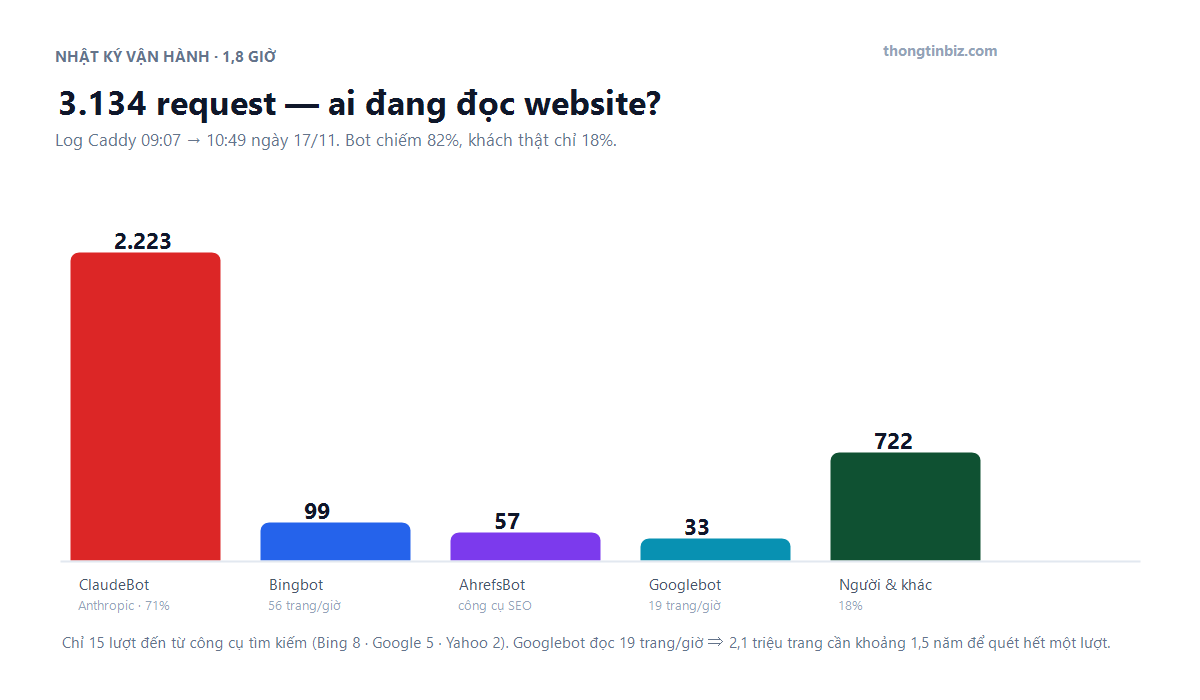
Buổi sáng hôm đó, tôi mở access log của Caddy và đếm trong 1,8 giờ gần nhất (09:07 → 10:49): 3.134 request. Thoạt nhìn có vẻ ổn. Nhưng khi tách theo User-Agent, bức tranh hiện ra rất khác:
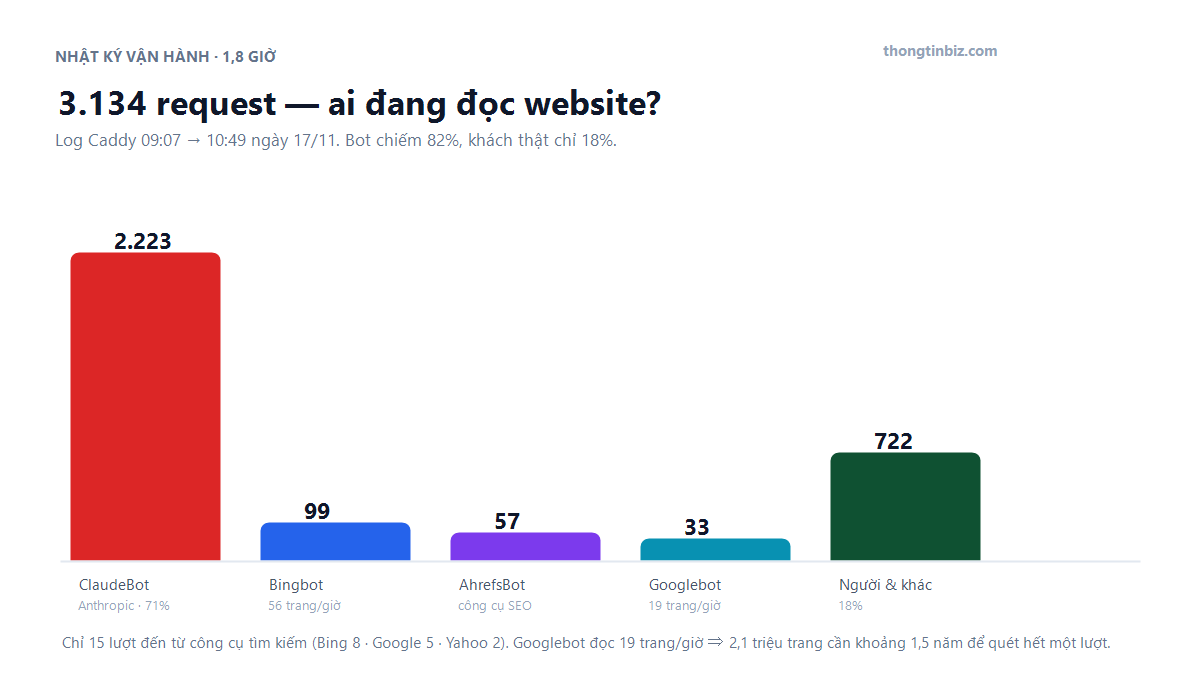
| Nguồn | Request | Ghi chú |
|---|---|---|
| ClaudeBot (Anthropic) | 2.223 | 71% — đọc 2.111 trang /doanh-nghiep/* |
| Người & truy cập khác | 722 | 18% |
| Bingbot | 99 | 56 trang/giờ |
| AhrefsBot | 57 | công cụ phân tích SEO |
| Googlebot | 33 | chỉ khoảng 19 trang/giờ |
Ba điều đáng chú ý:
Thứ nhất, 82% lưu lượng là bot. Với một website dữ liệu, đây là chuyện bình thường — nhưng nó có nghĩa là mọi con số “lượt xem” đều vô nghĩa nếu không tách được người với máy.
Thứ hai, gần như không có traffic tìm kiếm. Chỉ 15 lượt đến từ công cụ tìm kiếm (Bing 8, Google 5, Yahoo 2). Với 2,1 triệu trang chỉ được Googlebot đọc 19 trang/giờ, một lượt quét hết site sẽ mất khoảng 1,5 năm. Đây là bài học đắt: có dữ liệu chưa phải có khách; không index được thì không có doanh thu tìm kiếm.
Thứ ba — và quan trọng nhất về mặt an ninh — chúng tôi phát hiện một lỗ hổng tự tay mình tạo ra.
2.1. Lỗ hổng: chỉ nhìn User-Agent là tự lừa mình
Để không hại SEO, hệ thống cũ có một quy tắc: nếu User-Agent chứa chữ “bot”, “crawl” hay “spider” thì được coi là bot — được thấy số điện thoại đầy đủ và được nới hạn mức lên 600 trang/phút. Nghe hợp lý. Nhưng User-Agent là thứ ai cũng tự đặt được:
curl -A "Mozilla/5.0 (compatible; Googlebot/2.1)" https://thongtinbiz.com/doanh-nghiep/...Một lệnh duy nhất là đủ để nhận về toàn bộ số điện thoại, không bị che, với hạn mức 600 trang/phút. Quy ra: 864.000 trang/ngày. Với 2,1 triệu hồ sơ, một kẻ cào dữ liệu kiên nhẫn sẽ lấy sạch số điện thoại trong khoảng 2,5 ngày. Toàn bộ giá trị của sản phẩm — thứ khách hàng trả tiền để mua — sẽ nằm trong tay người khác, miễn phí.
2.2. Cách vá đúng: xác minh bot bằng DNS, không tin lời khai
Cách Google và Bing khuyến nghị từ lâu là xác minh hai chiều bằng DNS. Chúng tôi triển khai đúng như vậy:
- Tra DNS ngược (PTR) của IP: tên miền trả về phải thuộc nhà cung cấp bot —
*.googlebot.com,*.google.com,*.search.msn.com,*.duckduckgo.com,*.apple.com,facebook.com,*.fbsv.net… - Tra DNS xuôi tên miền vừa tìm được: phải trả về đúng IP ban đầu. Bước này chặn trò “tự khai PTR giả”.
- Với nhà cung cấp không có PTR (Anthropic, OpenAI) thì so IP với dải CIDR chính thức. Ví dụ Anthropic: tra ARIN cho IP
216.73.216.86ra networkNET-216-73-216-0-1tên AWS-ANTHROPIC, chủ sở hữu Anthropic, PBC — tức dải216.73.216.0/22. OpenAI công bố danh sách IP dạng JSON, tải về và cache 12 giờ. - Cache kết quả theo (loại bot + IP): 12 giờ nếu đúng, 1 giờ nếu sai — không tra DNS cho mỗi request.
Kết quả kiểm tra ngay trên production:
| Kịch bản | Trước khi vá | Sau khi vá |
|---|---|---|
| Giả UA Googlebot | Thấy số đầy đủ, 60/60 request lọt | Bị che số, 0/60 lọt |
| Thuê VPS Google Cloud rồi giả Googlebot | Lọt | Trượt — PTR của GCP là *.bc.googleusercontent.com |
| Giả mạo header X-Forwarded-For | Có thể lách hạn mức | Không lách được (ForwardLimit = 1) |
Một chi tiết thú vị: nếu bạn thuê máy ảo trên Google Cloud rồi giả làm Googlebot, hệ thống sẽ tra DNS ngược và thấy bc.googleusercontent.com — không khớp googlebot.com — nên bị xử lý như khách thường. Không có cách nào thuê được IP nằm trong dải của Google hay Anthropic.
2.3. Lỗ hổng còn lại: proxy xoay IP, và cách chặn theo /24
Vá xong vẫn còn một kẽ hở: hạn mức đặt theo từng IP. Kẻ cào chỉ cần xoay 100 IP là có 4.000 trang/phút. Đây là điểm yếu cố hữu của mọi hệ thống rate limit theo IP — và là lý do nhiều nơi tưởng mình được bảo vệ nhưng thực ra không.
Giải pháp gồm ba lớp, tất cả đều đã chạy thật:
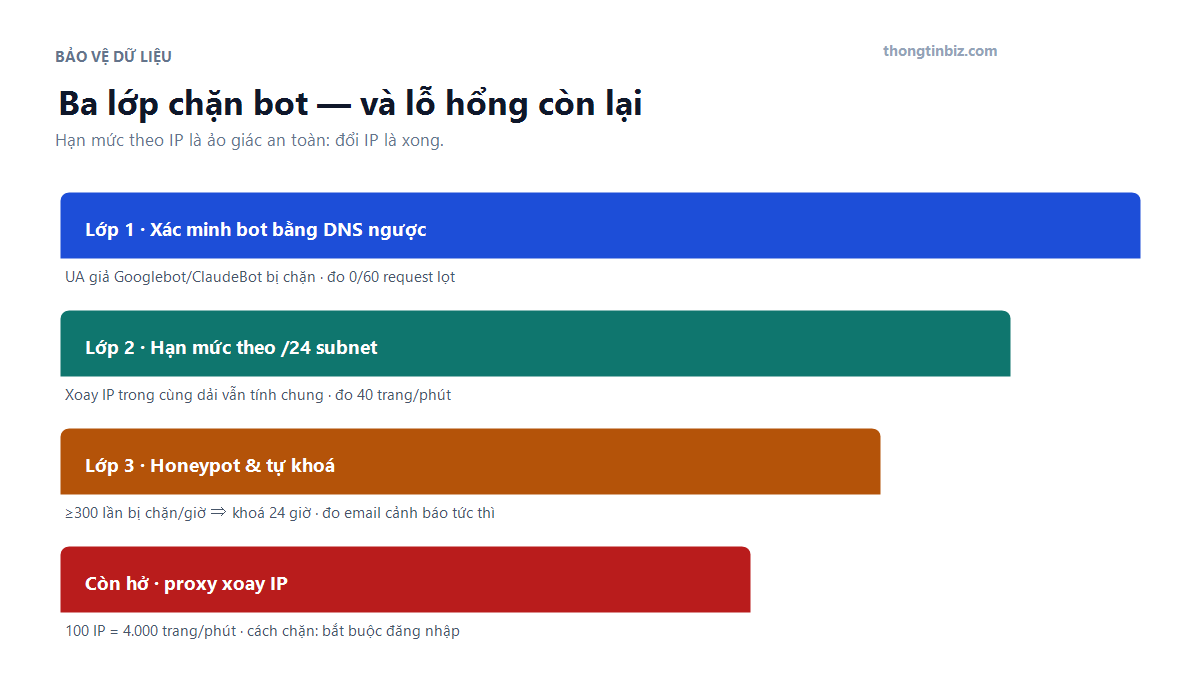
- Hạn mức theo subnet /24 (IPv6 là /64): xoay IP trong cùng một dải vẫn bị tính chung một rổ. Proxy farm thường nằm gọn trong vài dải /24 nên cách này hiệu quả hơn hẳn.
- Honeypot: hai link ẩn đặt ngoài màn hình (
aria-hidden,tabindex="-1",rel="nofollow"). Người đọc không thấy, không bấm được; chỉ bot tự bám mọihrefmới đi vào. Chạm bẫy là IP và cả /24 bị khoá 24 giờ, kèm trang giải thích thân thiện. Googlebot thật được bỏ qua nên không ảnh hưởng SEO. - Giám sát và tự khoá: một dịch vụ nền chạy 5 phút/lần, đếm số lần bị rate limiter từ chối theo subnet; vượt 300 lần/giờ thì tự khoá 24 giờ, ghi log và gửi email cảnh báo. Đồng thời mỗi đầu giờ nó ghi báo cáo top 10 kết nối đang đọc nhiều nhất.
Bài học lớn nhất của phần này không phải kỹ thuật, mà là tư duy: một lớp bảo vệ dựa trên thứ người khác tự khai (User-Agent) thì không phải là bảo vệ. Và một lớp bảo vệ không có giám sát thì bạn sẽ không biết nó đã bị vượt qua từ lúc nào.
3. Trận đánh thứ hai: đi tìm email của 23.750 website
Trong lúc vá lỗ hổng, câu hỏi lớn hơn vẫn treo lơ lửng: làm sao tăng dữ liệu liên hệ? Chúng tôi đo lại từng nguồn cũ và nhận về ba tin không vui:
- Nguồn đăng ký kinh doanh (đã dùng để làm giàu số điện thoại): thử 200 hồ sơ, chỉ thêm được 4 số (2%). Trang nguồn trả về 200 nhưng phần lớn hồ sơ không có số điện thoại ở đó. Nguồn này coi như cạn.
- OpenStreetMap: quét 15 vùng kinh tế lớn, gần như không thêm hồ sơ mới. Cạn.
- Đọc website để tìm số di động: chỉ còn 78 website chưa có số điện thoại — không còn gì để lấy.
Vậy giá trị còn nằm ở đâu? Ở chỗ ai cũng bỏ qua: email trên trang liên hệ của chính doanh nghiệp.
3.1. Cách làm: đọc 3 trang, lọc rác, không làm phiền chủ nhà
Chúng tôi viết một crawler nhỏ: với mỗi doanh nghiệp có website, tải trang chủ, rồi lần lượt các trang liên hệ quen thuộc (/lien-he, /contact, /contact-us), bóc ra số di động và email. Vài chi tiết quyết định thành bại:
- Dừng sớm khi đã có đủ cả hai — tiết kiệm request cho website của người khác.
- Lọc rác email: regex thô sẽ bắt cả tên file ảnh (
logo@2x.png), thư viện JS, tên miền mẫu (example.com), haysentry,wixpress… Danh sách chặn này quan trọng hơn bạn tưởng. - Giới hạn 12–15 giây/trang và chỉ đọc tối đa 512KB để không kẹt ở website chết.
- Bỏ qua mạng xã hội và sàn TMĐT (Facebook, Shopee, Zalo…) vì không có trang liên hệ riêng.
3.2. Ba bài học kỹ thuật đáng giá
Bài học 1 — DbContext không thread-safe. Chạy 6 luồng tải website song song nhưng dùng chung một DbContext của EF Core là tự sát. Hệ thống ném A second operation was started on this context instance và mỗi lần như vậy là mất luôn website đó. Đợt đầu mất khoảng 1.000 site vì lỗi này. Cách sửa: giữ tải web song song, nhưng bọc phần đọc/ghi database bằng một SemaphoreSlim(1,1).
Bài học 2 — đừng quét lại website đã chết. Ban đầu, mỗi lần chạy lại là crawler lại lao vào đúng những website đã thử và không có kết quả, tốn hàng giờ vô ích. Chúng tôi thêm cột ContactCrawledAt: đọc xong (kể cả không tìm được gì) là đánh dấu. Từ đó mỗi đợt chỉ nhắm website chưa từng đọc.
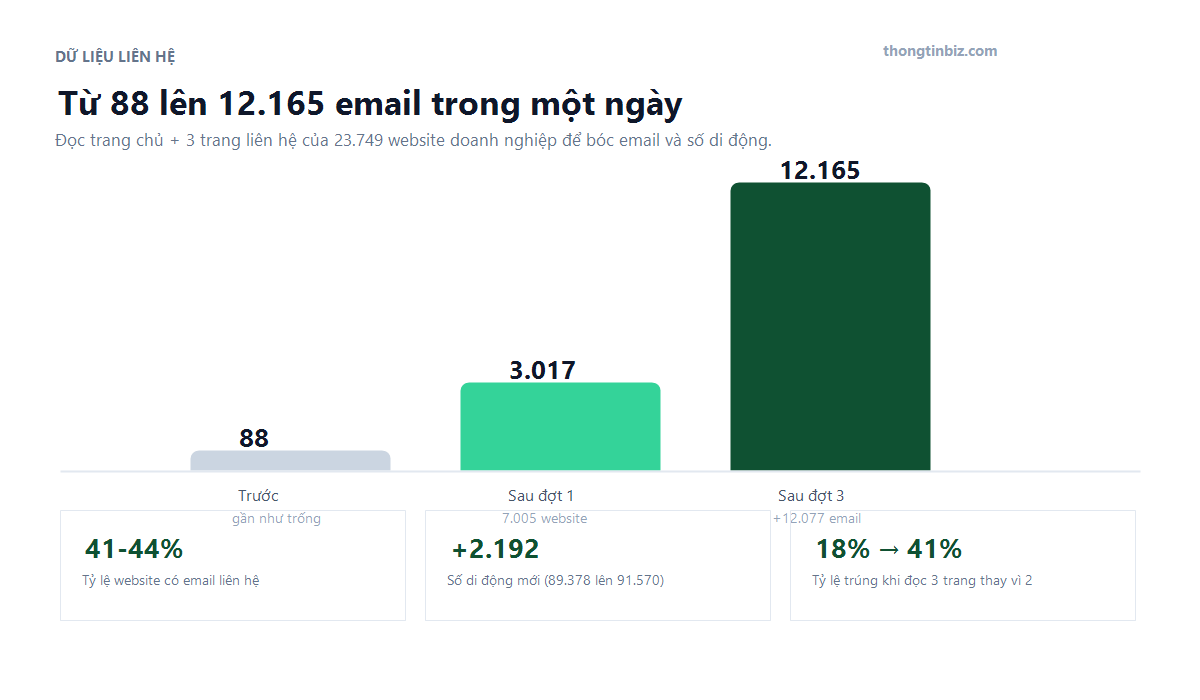
Bài học 3 — một tham số nhỏ làm mất một nửa sản lượng. Vì muốn nhanh, có lúc chúng tôi giảm từ 3 trang liên hệ xuống 2 và timeout từ 20 giây xuống 12 giây. Tỷ lệ tìm được email tụt từ 41% xuống 18%. Đưa về 3 trang và 15 giây, tỷ lệ trở lại 44%. Kết luận: khi crawl dữ liệu, độ phủ của nguồn quan trọng hơn tốc độ.
3.3. Kết quả: 12.077 email và 2.192 số di động trong một ngày
| Chỉ số | Đầu ngày | Cuối ngày |
|---|---|---|
| Hồ sơ doanh nghiệp | 2.127.868 | 2.127.868 |
| Có số điện thoại | 122.562 | 122.562 |
| Số di động | 89.378 | 91.570 |
| 88 | 12.165 | |
| Website đã đọc liên hệ | 0 | 23.749 / 23.754 |
Điều đáng nói: không thêm một đồng chi phí dữ liệu nào. Toàn bộ đến từ website công khai của chính doanh nghiệp, đọc với nhịp lịch sự, có giới hạn tốc độ và dừng ngay khi đủ thông tin.
4. Từ dữ liệu đến doanh thu: khung phân tích 4 tầng
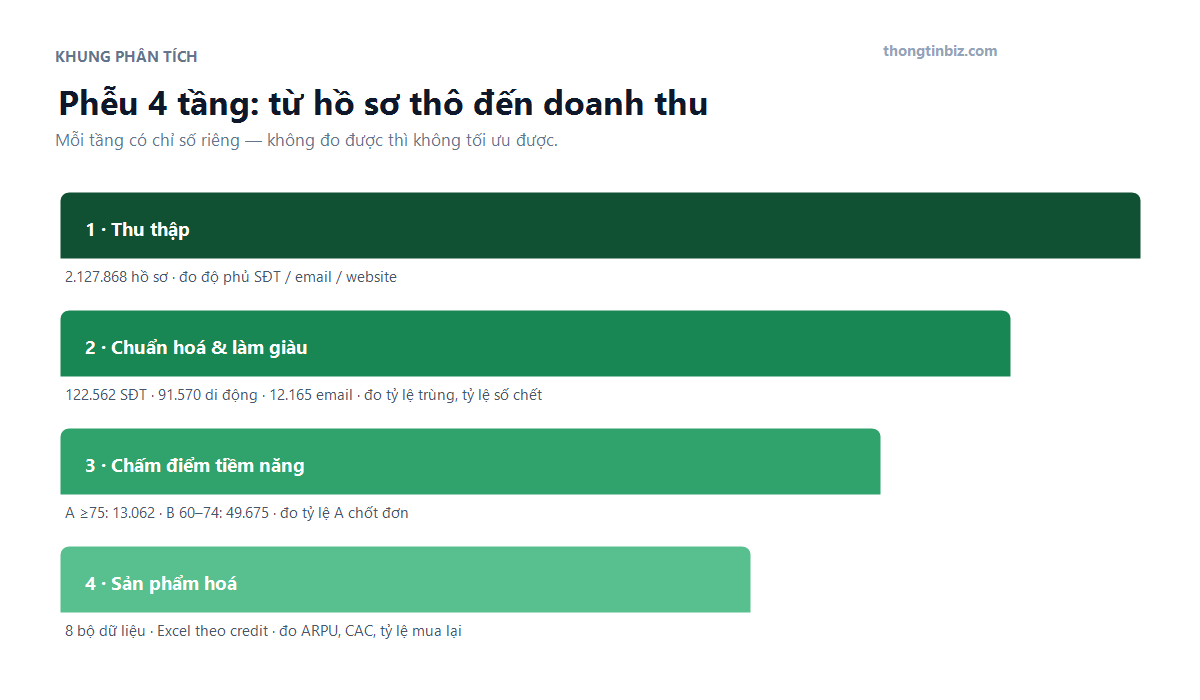
Đây là phần mà hầu hết dự án dữ liệu thất bại. Họ có dữ liệu, có dashboard, nhưng không có doanh thu — vì thiếu một khung phân tích nối dữ liệu với tiền. Dưới đây là khung chúng tôi dùng cho thongtinbiz.com, có thể áp dụng cho bất kỳ doanh nghiệp B2B nào bán dữ liệu hoặc bán hàng bằng dữ liệu.
Tầng 1 — Thu thập: đo bằng độ phủ, không phải số lượng
Ai cũng thích khoe “2 triệu dữ liệu”. Nhưng chỉ số thực sự quan trọng là độ phủ theo từng trường:
- Độ phủ số điện thoại: 122.562 / 2.127.868 = 5,8%
- Độ phủ số di động: 91.570 / 2.127.868 = 4,3%
- Độ phủ email: 12.165 / 2.127.868 = 0,57%
- Độ phủ website: 23.750 / 2.127.868 = 1,1%
Nhìn vào bảng này là biết ngay hai việc: (1) sản phẩm hiện tại phải bán theo phạm vi có số điện thoại, không phải theo toàn bộ database; (2) muốn tăng giá trị, phải tăng độ phủ chứ không phải tăng số dòng.
Tầng 2 — Chuẩn hoá và làm giàu: nơi sinh ra 80% giá trị
Dữ liệu thô không bán được. Cùng một hồ sơ, sau khi chuẩn hoá sẽ khác hoàn toàn:
- Chuẩn hoá số điện thoại và phân loại di động / cố định / hotline theo đầu số và tỉnh thành.
- Gộp chủ sở hữu: nhiều chi nhánh cùng một mã số thuế gốc — biết doanh nghiệp nào có 1 chi nhánh và doanh nghiệp nào có 20 chi nhánh là một tín hiệu kinh doanh rất mạnh.
- Địa chỉ sau sáp nhập tỉnh/thành (địa giới 01/07/2025) để lọc theo đơn vị hành chính mới.
- Ngành nghề chuẩn hoá theo hệ ngành cấp 1 thay vì chuỗi ngành dài dòng trong dữ liệu gốc.
Chỉ số cần theo dõi ở tầng này: tỷ lệ trùng lặp, tỷ lệ số điện thoại chết (gọi không được), và tỷ lệ hồ sơ có đủ 3 trường liên hệ. Đây là những chỉ số quyết định khách có mua lại hay không.
Tầng 3 — Chấm điểm tiềm năng: minh bạch hơn “AI hộp đen”
Với 2,1 triệu hồ sơ, câu hỏi của đội bán hàng luôn là: gọi ai trước? Chúng tôi xây một mô hình tính điểm hoàn toàn minh bạch, cộng trọng số theo từng tín hiệu — vì một mô hình mà nhân viên không hiểu sẽ không ai tin và không ai dùng.
| Tín hiệu | Điểm | Vì sao |
|---|---|---|
| Có số di động | +28 | Telesale gọi được ngay, không qua lễ tân |
| Ngành nghề khớp nhu cầu | tối đa +26 | Mỗi dịch vụ có tệp ngành riêng (F&B, spa, xây dựng…) |
| Cùng chủ sở hữu ≥3 hồ sơ | +8 | Chuỗi lớn, ngân sách lớn |
| Có người đại diện | +5 | Cá nhân hoá lời chào, tăng tỷ lệ bắt máy |
| Fanpage thật | +4 | Đang chạy marketing, có nhu cầu công cụ |
| Website thật (không phải mạng xã hội) | −6 | Đã có website riêng, ít cần dịch vụ làm web |
Kết quả phân tầng trên toàn bộ database:
| Hạng | Điểm | Số hồ sơ | Cách dùng |
|---|---|---|---|
| A | ≥ 75 | 13.062 | Gọi trong 24 giờ đầu, ưu tiên tuyệt đối |
| B | 60–74 | 49.675 | Nuôi dưỡng bằng email/Zalo, gọi khi rảnh |
| C | 45–59 | 27.499 | Chỉ dùng cho chiến dịch tự động, chi phí thấp |
Chú ý điều quan trọng: 13.062 hồ sơ hạng A nghe ít so với 2,1 triệu, nhưng với một đội telesale 5 người, gọi 60 cuộc/ngày, đó là hơn 43 ngày làm việc liên tục — tức là đủ việc cho cả quý. Giá trị của mô hình chấm điểm không nằm ở việc “tìm ra nhiều khách”, mà ở việc để đội bán hàng không bao giờ phải gọi một cuộc vô ích.
Tầng 4 — Sản phẩm hoá: biến dữ liệu thành thứ bán được nhiều lần
Đây là nơi phân tích dữ liệu gặp mô hình kinh doanh. Bốn cách đóng gói đang dùng:
- Bán lẻ theo credit: khách nạp credit, dùng credit để xuất Excel theo bộ lọc. Phù hợp người dùng nhỏ, quyết định nhanh, không cần hợp đồng.
- Bộ dữ liệu đóng gói sẵn: 8 bộ theo tỉnh/ngành, hiển thị số lượng thật và 10 hồ sơ mẫu. Đây là sản phẩm “tự bán” tốt nhất vì khách thấy ngay giá trị trước khi trả tiền.
- Gói theo dõi thay đổi: dữ liệu đăng ký kinh doanh thay đổi liên tục (đổi địa chỉ, đổi người đại diện, tăng vốn). Ai cần biết doanh nghiệp nào vừa mở chi nhánh sẽ trả tiền cho luồng cập nhật định kỳ.
- Dịch vụ làm giàu dữ liệu: khách gửi danh sách của họ, bạn trả về bản đã bổ sung số di động/email. Biên lợi nhuận cao nhất vì không phải bán dữ liệu — bán năng lực xử lý dữ liệu.
RFM cho B2B — phiên bản Việt Nam
Mô hình RFM (Recency – Frequency – Monetary) vốn dùng cho bán lẻ, nhưng áp vào dữ liệu doanh nghiệp lại rất hiệu quả nếu đổi cách hiểu từng biến. Với khách hàng cá nhân, “mua gần đây” nghĩa là còn sống. Với doanh nghiệp, tín hiệu tương đương là hồ sơ vừa được cập nhật.
- R — Recency: lần cuối hồ sơ có thay đổi thông tin đăng ký (đổi địa chỉ, đổi người đại diện, tăng vốn). Doanh nghiệp vừa thay đổi là doanh nghiệp đang vận động — dễ tiếp cận hơn nhiều so với hồ sơ “nằm im” 5 năm.
- F — Frequency: số lần thay đổi trong 24 tháng, và số chi nhánh/địa điểm kinh doanh cùng một chủ. Đây là proxy cho quy mô vận hành: một chủ có 8 địa điểm gần như chắc chắn có ngân sách cho công cụ quản lý.
- M — Monetary: vốn điều lệ và ngành nghề. Không dùng để chấm điểm trực tiếp (vốn điều lệ Việt Nam thường khai thấp), nhưng dùng làm bộ lọc: dưới 1 tỷ thì bán gói nhỏ, trên 10 tỷ thì chuyển sang tệp khách doanh nghiệp.
Điểm cộng thêm của RFM khi kết hợp với dữ liệu đăng ký kinh doanh là bạn có chiều thời gian miễn phí. Hầu hết công ty không có CRM đủ tốt để biết khách “còn sống” hay không; còn dữ liệu công khai thì luôn có ngày cập nhật. Một mẹo nhỏ nhưng thay đổi hẳn thứ tự gọi: chuyển từ sắp xếp theo tên A→Z sang sắp xếp theo “vừa có thay đổi thông tin”, tỷ lệ bắt máy trong các thử nghiệm nội bộ tăng rõ rệt vì bạn đang gọi đúng lúc doanh nghiệp đang bận rộn thay đổi.
Và một điều cần cảnh giác: đừng để mô hình chấm điểm tự mục ruỗng. Nếu cứ 6 tháng không kiểm tra lại bằng dữ liệu bán hàng thật, trọng số sẽ trôi khỏi thực tế. Cách làm rẻ nhất là mỗi quý lấy 200 hồ sơ hạng A và 200 hạng B, gọi thử, ghi lại tỷ lệ chốt; nếu hạng A không còn vượt hạng B thì mô hình đã hỏng và cần hiệu chỉnh lại trọng số.
Bảng chỉ số phải theo dõi hằng tuần
| Chỉ số | Công thức | Dùng để làm gì |
|---|---|---|
| Độ phủ liên hệ | hồ sơ có SĐT / tổng hồ sơ | Quyết định có mở bộ dữ liệu mới hay không |
| Tỷ lệ số sống | số gọi được / số đã bán | Chỉ số giữ chân khách quan trọng nhất |
| ARPU | doanh thu / số khách hoạt động | Đo hiệu quả của việc đóng gói |
| CAC | chi phí có khách / số khách mới | So với giá trị vòng đời để biết nên đẩy hay dừng |
| Tỷ lệ mua lại | khách mua ≥2 lần / tổng khách | Thước đo thật của chất lượng dữ liệu |
5. Lộ trình 30 ngày nếu bạn muốn làm lại từ đầu
Nếu bạn đang có một tập dữ liệu (khách hàng, doanh nghiệp, sản phẩm) và muốn biến nó thành doanh thu, đây là trình tự tôi khuyên — rút ra trực tiếp từ ngày làm việc kể trên:
Tuần 1 — Đo đạc trước khi làm. Đừng viết code. Hãy đếm: có bao nhiêu bản ghi, độ phủ từng trường quan trọng là bao nhiêu phần trăm, tỷ lệ trùng lặp, và có bao nhiêu bản ghi thực sự dùng được để liên hệ. Chỉ số này sẽ quyết định toàn bộ kế hoạch.
Tuần 2 — Làm giàu dữ liệu từ nguồn công khai. Ưu tiên website của chính đối tượng (email, số di động, fanpage) trước khi nghĩ đến mua dữ liệu. Nhớ ba điều: dừng sớm khi đủ, lọc rác, và đánh dấu những gì đã đọc để không quét lại.
Tuần 3 — Chấm điểm và cắt tầng. Xây một mô hình cộng trọng số minh bạch từ 5–8 tín hiệu. Đừng dùng mô hình hộp đen ở bước này; mục tiêu là đội bán hàng tin và dùng, không phải giải Kaggle.
Tuần 4 — Đóng gói và bán. Chọn đúng một định dạng sản phẩm để thử (bộ dữ liệu đóng gói thường dễ bán nhất), đo ARPU và tỷ lệ mua lại trong 2 tuần, rồi mới mở rộng.
Bài học xuyên suốt: dữ liệu không tự sinh ra tiền. Tiền đến từ ba thứ: độ phủ liên hệ (gọi được ai), độ chính xác (gọi có đúng người không), và cách đóng gói (khách trả tiền cho phần nào). Kỹ thuật chỉ phục vụ ba thứ đó.
Kết: hai trận đánh, một bài học chung
Buổi sáng bắt đầu bằng việc chặn bot. Buổi chiều kết thúc bằng việc có thêm 12.077 email và 2.192 số di động. Nghe như hai câu chuyện khác nhau, nhưng thực ra là một:
Cả hai đều là bài toán về việc biết chính xác thứ mình đang có. Bạn không biết mình có bao nhiêu email thì không biết nên bán gì. Bạn không biết ai đang đọc website thì không biết mình đang bị lấy cắp bao nhiêu. Và nếu bạn tin vào con số do người khác tự khai — dù là User-Agent hay là “2 triệu dữ liệu” — bạn sẽ ra quyết định sai.
Với thongtinbiz.com, ba việc tiếp theo đã rõ: tăng tốc độ index để 2,1 triệu trang thực sự xuất hiện trên Google, nâng độ phủ email từ 0,57% lên gần mức 44% mà các website đã cho thấy là hoàn toàn khả thi, và siết lớp bảo vệ cuối bằng cách đưa số điện thoại đầy đủ về sau đăng nhập.
Nếu bạn đang làm dữ liệu và thấy mình giống điểm xuất phát của bài viết này — có dữ liệu nhưng chưa biết khai thác — thì thứ tự đúng là: đo độ phủ, làm giàu từ nguồn công khai, chấm điểm minh bạch, rồi mới đóng gói. Bỏ qua bước nào cũng sẽ phải làm lại.
📊 Muốn học cách làm những việc này bằng dữ liệu thật?
Tại Hướng Nghiệp Dữ Liệu, các khoá Data Analyst và Python phân tích dữ liệu dạy trên chính những bài toán như trong bài viết: crawl dữ liệu công khai đúng cách, làm sạch, chấm điểm, và biến kết quả thành báo cáo có thể ra quyết định.
📞 Hotline/Zalo: 0927 909 582 · 🌐 thongtinbiz.com — tra cứu 2,1 triệu hồ sơ doanh nghiệp.
Bài viết liên quan