thongtinbiz.com cung cấp gì? Dịch vụ dữ liệu doanh nghiệp và Backend phía sau
Mục lục bài viết
thongtinbiz.com là website tra cứu và cung cấp dữ liệu doanh nghiệp Việt Nam. Nhưng nếu chỉ dừng ở câu đó thì chưa đủ để bạn biết nó bán gì, giá trị nằm ở đâu, và tại sao phía sau một trang tra cứu đơn giản lại là một hệ thống backend phải xử lý 2,1 triệu dòng, chống bot cào dữ liệu, và tối ưu từng mili-giây.
Bài viết này gồm hai phần rõ ràng. Phần một nói về dịch vụ: bạn mua gì, dùng như thế nào, dữ liệu có độ phủ ra sao và cách chúng tôi đo chất lượng. Phần hai mở toang phần backend — kiến trúc, database, bảo mật, pipeline làm giàu dữ liệu, cách vận hành, và những bài học nghề đáng giá nhất. Cuối bài là lộ trình 90 ngày cùng các khoá học Backend liên quan tại Hướng Nghiệp Dữ Liệu, dành cho ai muốn tự tay dựng một hệ thống tương tự.
PHẦN 1 — thongtinbiz.com cung cấp những dịch vụ gì?
1. Tra cứu doanh nghiệp miễn phí
Đây là phần mở cửa cho tất cả mọi người, không cần đăng ký. Bạn nhập tên công ty, mã số thuế, số điện thoại hoặc tên người đại diện và nhận về hồ sơ đầy đủ:
- Mã số thuế (kèm nhãn loại hình: doanh nghiệp, hộ kinh doanh, chi nhánh, địa điểm kinh doanh)
- Tên quốc tế và tên viết tắt nếu có
- Địa chỉ trước sáp nhập và địa chỉ sau sáp nhập (theo địa giới 01/07/2025) — chi tiết này quan trọng vì rất nhiều danh sách cũ vẫn dùng đơn vị hành chính đã hết hiệu lực
- Ngành nghề chính (hệ ngành cấp 1) và chuỗi ngành nghề kinh doanh đầy đủ
- Người đại diện pháp luật + chức danh
- Điện thoại, email, website nếu có
- Vốn điều lệ, cơ quan thuế quản lý, trạng thái hoạt động, ngày đăng ký
- Lịch sử thay đổi thông tin đăng ký: đổi địa chỉ, đổi người đại diện, tăng vốn…
Mỗi doanh nghiệp có một trang riêng với URL cố định dạng /doanh-nghiep/<slug> và một URL rút gọn theo mã số thuế /ma-so-thue/<mst>. Cách đặt URL này không phải ngẫu nhiên: người dùng thường chỉ nhớ mã số thuế, còn công cụ tìm kiếm cần URL có nghĩa. Hai nhu cầu khác nhau, nên hệ thống phục vụ cả hai và tự chuyển hướng 301 về URL chuẩn.
Ngoài ra còn có các trang danh mục để đi từ tổng quan đến chi tiết:
- /tinh-thanh — 34 tỉnh/thành, mỗi tỉnh có danh sách doanh nghiệp phân trang
- /nganh-nghe — doanh nghiệp theo hệ ngành nghề
- /du-lieu — các bộ dữ liệu đóng gói sẵn
Giới hạn của bản miễn phí được thiết kế để vừa đủ dùng thử, không đủ để cào: khách vãng lai chỉ thấy số điện thoại đầy đủ ở trang đầu tiên; từ trang thứ hai số được che dạng 0904•••986. Tài khoản đã đăng nhập thấy đầy đủ, không giới hạn số trang.
2. Xuất Excel theo đúng bộ lọc của bạn
Đây là dịch vụ được dùng nhiều nhất. Thay vì tải một file khổng lồ rồi tự lọc, bạn lọc trước rồi mới tải:
- Lọc theo từ khoá (tên công ty, mã số thuế)
- Lọc theo tỉnh/thành và ngành nghề
- Bật chỉ doanh nghiệp có số di động — bộ lọc quan trọng nhất với telesale
Trang /xuat-excel hiển thị ngay số dòng khớp điều kiện và 20 dòng xem trước miễn phí. Khi bấm tạo file, hệ thống:
- Kiểm tra bạn đã đăng nhập và còn credit
- Sinh file Excel bằng ClosedXML, có tiêu đề cột rõ ràng, đúng định dạng ngày và số
- Cấp một token tải dùng một lần (hết hạn sau 30 phút), file lưu ngoài thư mục web nên không ai đoán được đường dẫn
- Ghi lại lịch sử để bạn xem lại trong trang tài khoản
Mỗi lần xuất tốn 1 credit, tối đa 20.000 dòng mỗi file. Credit không hết hạn — nạp một lần dùng dần.
3. Tám bộ dữ liệu đóng gói sẵn
Không phải ai cũng muốn tự lọc. Nhiều khách chỉ cần “cho tôi danh sách quán ăn ở TP.HCM có số di động”. Với họ, bộ dữ liệu đóng gói sẵn là câu trả lời nhanh nhất — mở trang, thấy số lượng thật, xem 10 hồ sơ mẫu, rồi quyết định.
| Bộ dữ liệu | Phù hợp với |
|---|---|
| Data telesale toàn quốc | Đội sale nhiều tỉnh, chuỗi, nhượng quyền |
| Data telesale TP.HCM / Hà Nội / Hải Phòng | Sale khu vực, gọi trong giờ hành chính |
| Nội thất TP.HCM | Xưởng nội thất, đại lý vật liệu, thi công |
| Xây dựng — kiến trúc TP.HCM | Nhà thầu phụ, vật tư, thiết bị |
| Nhà hàng — ăn uống TP.HCM | POS, nguyên liệu, marketing F&B |
| Y tế — phòng khám TP.HCM | Thiết bị y tế, phần mềm phòng khám, dược |
Điểm quan trọng: số lượng hiển thị là số thật đang có trong database, không phải con số marketing. Khách bấm mua rồi không bị hụt hàng — đây là thứ giữ chân khách tốt hơn mọi lời quảng cáo.
4. Dịch vụ làm giàu dữ liệu (data enrichment)
Đây là dịch vụ ít người biết nhưng biên lợi nhuận cao nhất. Bạn gửi danh sách của mình (Excel 500 dòng, 5.000 dòng hay 50.000 dòng), chúng tôi trả về bản đã bổ sung:
- Số điện thoại / số di động còn thiếu
- Email liên hệ và website
- Thông tin đăng ký đầy đủ theo mã số thuế
- Điểm tiềm năng (hạng A/B/C) để bạn biết nên gọi trước
Vì sao khách cần dịch vụ này thay vì mua data mới? Vì danh sách cũ của họ đã được đội sale ghi chú, phân loại, có lịch sử chăm sóc. Làm giàu danh sách cũ giữ được toàn bộ ngữ cảnh đó — điều mà mua data mới không làm được.
6. Quy trình mua và thanh toán
Một điểm thường bị bỏ qua khi nói về sản phẩm dữ liệu: trải nghiệm mua hàng quan trọng ngang với chất lượng dữ liệu. Nếu khách phải gọi điện, chờ báo giá, chuyển khoản thủ công rồi chờ gửi file, phần lớn sẽ bỏ đi giữa chừng. Quy trình hiện tại gói trong bốn bước, tất cả tự động:
- Đăng ký bằng email và nhận mã kích hoạt để xác thực tài khoản
- Chọn gói credit và thanh toán bằng chuyển khoản qua VietQR
- Hệ thống đối soát tự động qua webhook của cổng thanh toán: đúng nội dung chuyển khoản là credit được cộng ngay, không cần người xử lý
- Xuất dữ liệu theo bộ lọc, tải file bằng token dùng một lần
Mỗi credit được ghi vào một sổ cái (credit ledger) theo nguyên tắc chỉ ghi thêm, không sửa: nạp bao nhiêu, dùng cho đơn nào, còn lại bao nhiêu. Khi có khiếu nại, chỉ cần mở sổ ra là biết chính xác chuyện gì đã xảy ra. Đây là nguyên tắc kế toán cơ bản nhưng rất nhiều sản phẩm số bỏ qua, để rồi khi tranh chấp thì không ai đối chiếu được.
Với người dùng doanh nghiệp, tất cả đơn hàng đều có mã đơn và có thể xuất lại hóa đơn. Với quản trị viên, mọi thao tác cộng trừ credit, khoá tài khoản, cấp quyền đều ghi vào nhật ký kiểm toán — không có thao tác nào “âm thầm” được thực hiện.
7. Chất lượng dữ liệu: cách chúng tôi đo
Một website dữ liệu sống hay chết nằm ở chỗ dám công bố chỉ số. Dưới đây là số liệu thật tại thời điểm viết bài:
| Chỉ số | Giá trị | Ý nghĩa |
|---|---|---|
| Tổng hồ sơ | 2.127.868 | Toàn bộ dữ liệu đăng ký đang lưu |
| Có số điện thoại | 122.562 | 5,8% — phần bán được ngay |
| Trong đó là số di động | 91.570 | Loại số telesale cần nhất |
| Có email liên hệ | 12.165 | Dùng cho email marketing, ít bị chặn |
| Có website | 23.750 | Tín hiệu doanh nghiệp đang đầu tư marketing |
Con số 5,8% nghe nhỏ, nhưng hãy nhìn theo hướng khác: 122.562 hồ sơ có số điện thoại là gấp nhiều lần số doanh nghiệp một đội sale 10 người có thể gọi trong một năm. Và ở góc độ sản phẩm, chính tỷ lệ thấp này cho biết việc làm giàu dữ liệu còn rất nhiều đất — đó là lý do dịch vụ số 4 tồn tại.
PHẦN 2 — Backend phía sau: 6 khối, không có gì thừa
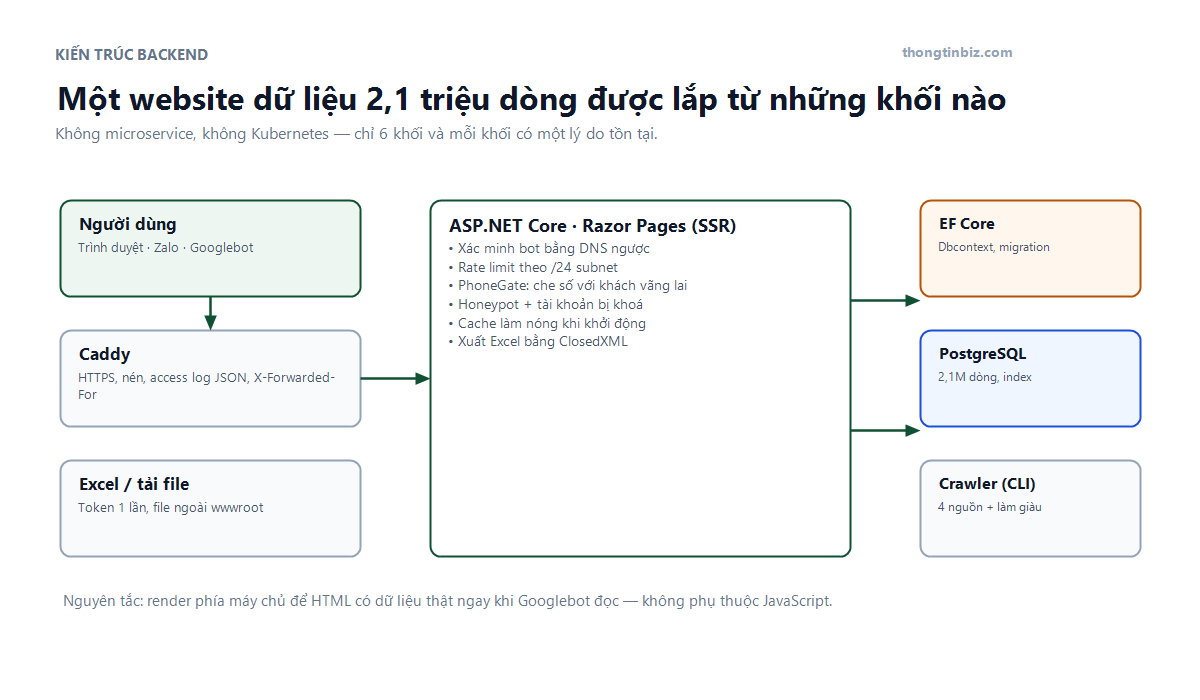
Nhiều người tưởng một hệ thống 2,1 triệu dòng phải là microservice, Kubernetes, hàng chục container. Thực tế thì ngược lại: hệ thống càng nhỏ càng dễ vận hành, và dễ vận hành là một dạng tính năng.
1. Vì sao chọn Razor Pages render phía máy chủ
Với một website có 2,1 triệu trang, mỗi trang cần được Googlebot đọc. Nếu chọn SPA (React/Vue tải dữ liệu bằng JavaScript), Googlebot phải chạy JS mới thấy nội dung — chậm, tốn tài nguyên, và tỷ lệ index thấp hơn hẳn. Razor Pages trả về HTML có dữ liệu thật ngay từ byte đầu tiên. Toàn bộ trang chi tiết doanh nghiệp dưới 100KB HTML, tải xong trong khoảng 250ms.
Đánh đổi: mỗi lần bấm link là một lần tải trang. Nhưng với nội dung dữ liệu — nơi người dùng đọc thông tin rồi rời đi — điều đó không phải vấn đề. Chọn kiến trúc theo cách người dùng thật sự dùng sản phẩm, không theo xu hướng. Nếu bạn muốn hiểu sâu hơn về vai trò của backend trong một sản phẩm, bài Backend là gì là điểm bắt đầu phù hợp.
2. Mô hình dữ liệu
Chỉ một bảng chính, vài bảng phụ — nhưng mỗi bảng phục vụ một câu hỏi kinh doanh cụ thể:
Companies— hồ sơ doanh nghiệp: mã số thuế, tên, địa chỉ, ngành nghề, người đại diện, liên hệ, trạng thái, và các cột phục vụ vận hành nhưLastCrawledAt,ContactCrawledAtCompanyChanges— lịch sử thay đổi thông tin đăng ký (nguồn dữ liệu quý: doanh nghiệp vừa đổi địa chỉ là doanh nghiệp đang vận động)CompanyLeadScores— điểm tiềm năng đã tính sẵn, để truy vấn “top 1.000 hạng A” không phải chấm lại 2,1 triệu dòngUsers,CreditLedgers,Orders,PaymentTransactions— tài khoản, sổ credit, đơn hàng, giao dịch thanh toánExportJobs— mỗi lần xuất Excel là một job có token tải, hết hạn, dùng một lầnPageViews— lượt xem theo khoá trang, dùng UPSERT nguyên tử để nhiều request đồng thời không ghi đè nhauAdminAuditLogs— mọi thao tác quản trị đều ghi vết
Nghệ thuật chính ở đây là tách phần “tính toán nặng” ra khỏi đường truy cập. Điểm tiềm năng được tính theo lô và lưu lại; khi khách mở trang, hệ thống chỉ đọc một dòng trong bảng điểm. Không có thuật toán nào chạy trong request của người dùng.
3. Hiệu năng với 2,1 triệu dòng
Ba quyết định giữ cho hệ thống nhanh mà không cần hạ tầng lớn:
- Đếm và phân trang ở tầng database, không tải cả bảng về bộ nhớ. Đếm tổng số dòng theo bộ lọc là câu
COUNT(*)có index, không phải vòng lặp C#. - Cache làm nóng khi khởi động: các con số tổng (tổng hồ sơ, số tỉnh, số ngành) được tính một lần rồi giữ trong bộ nhớ. Trang chủ không đếm lại 2,1 triệu dòng cho mỗi lượt truy cập.
- Chỉ mục theo đúng truy vấn thật: tìm theo mã số thuế, theo slug, theo tỉnh + ngành + có số điện thoại. Không đánh index tràn lan — mỗi index thêm vào là một cái giá phải trả khi ghi dữ liệu.
Bài học ở đây rất đơn giản mà nhiều người bỏ qua: hiệu năng không đến từ phần cứng, nó đến từ việc biết truy vấn nào là truy vấn thật. Muốn luyện phần này, hãy bắt đầu từ SQL: SQL Server cơ bản và tạo và quản lý database.
4. Bảo mật: ba lớp chống cào dữ liệu
Với website dữ liệu, kẻ thù số một không phải hacker mà là bot cào dữ liệu. Nếu họ lấy được số điện thoại, sản phẩm bạn bán không còn giá trị. Ba lớp đang chạy:
Lớp 1 — Xác minh bot bằng DNS, không tin User-Agent. Hệ thống tra DNS ngược (PTR) của IP: phải thuộc tên miền nhà cung cấp bot; sau đó tra ngược tên miền đó xem có trả về đúng IP hay không. Với nhà cung cấp không công bố PTR (Anthropic, OpenAI), so IP với dải CIDR chính thức. Kết quả cache 12 giờ. Nhờ vậy, câu lệnh curl -A Googlebot không còn tác dụng: UA nói là bot nhưng IP không phải của Google thì bị xử lý như khách thường.
Lớp 2 — Hạn mức theo /24 subnet. Hạn mức theo từng IP là ảo giác an toàn: đổi IP là xong. Tính theo dải /24 khiến cả một proxy farm nằm trong cùng dải bị tính chung một rổ. Người xem bình thường: 40 trang/phút. Bot đã xác minh: 600 trang/phút.
Lớp 3 — Honeypot và tự khoá. Hai link ẩn (ngoài màn hình, không focus được, chặn trong robots.txt) chỉ bot tự bám mọi href mới đi vào. Chạm bẫy là IP và cả /24 bị khoá 24 giờ. Song song, một dịch vụ nền đếm số lần bị rate limiter từ chối: vượt 300 lần/giờ thì tự khoá, ghi log và gửi email cảnh báo.
Nếu bạn đang viết API và muốn biết mình đang hở ở đâu, bài 14 lỗ hổng REST API thực tế là danh sách đáng đọc trước khi deploy.
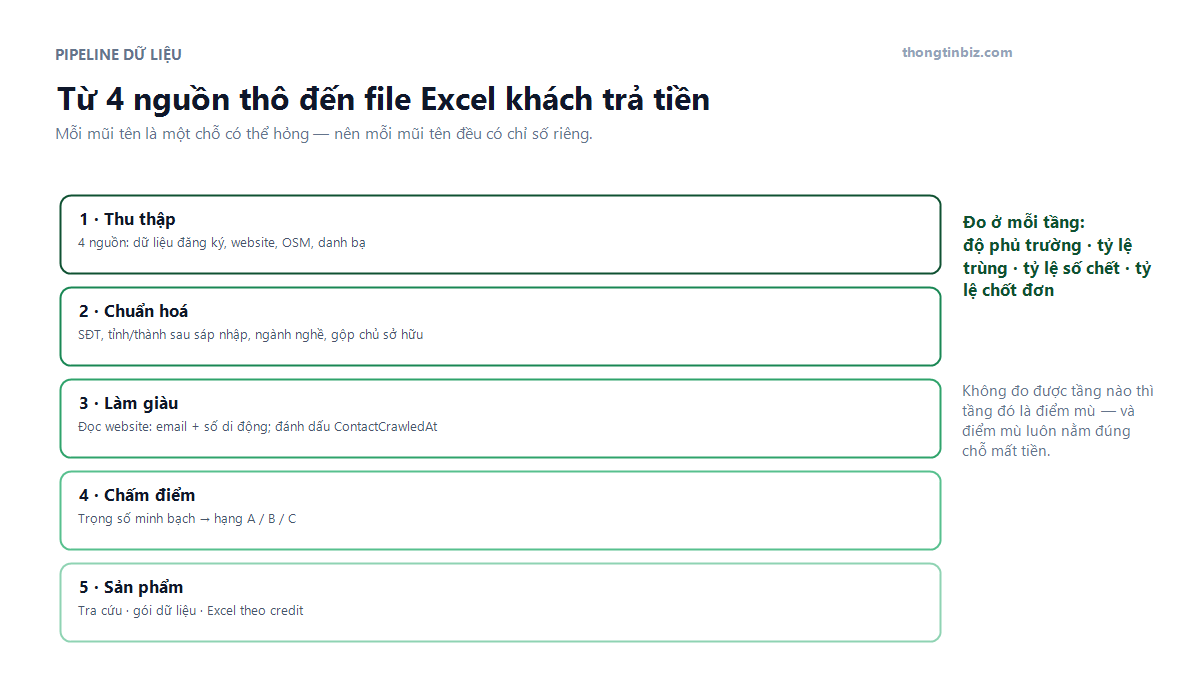
5. Pipeline làm giàu dữ liệu — nơi backend gặp dữ liệu bẩn
Đây là phần “không hào nhoáng” nhất nhưng sinh ra phần lớn giá trị. Crawler chạy dạng CLI riêng, không nằm trong tiến trình web, để có thể chạy dài giờ mà không ảnh hưởng người dùng. Bốn nhóm việc:
- Đọc website của chính doanh nghiệp để lấy email và số di động từ trang chủ + các trang liên hệ
- Đối chiếu nguồn đăng ký để bổ sung trường còn thiếu
- Chuẩn hoá: số điện thoại theo đầu số và tỉnh, địa chỉ theo địa giới mới, ngành nghề theo hệ cấp 1
- Đánh dấu đã xử lý (
ContactCrawledAt) để lần chạy sau không quét lại website chết
Ba lỗi nghề đáng nhớ, ai viết backend cũng sẽ gặp:
Thứ nhất — DbContext không thread-safe. Chạy 6 luồng tải website song song nhưng dùng chung một DbContext của EF Core sẽ ném A second operation was started on this context instance, và mỗi lần như vậy là mất một bản ghi. Cách sửa đúng: tải web song song, nhưng bọc phần đọc/ghi database bằng một SemaphoreSlim(1,1) — hoặc cấp DbContext riêng cho mỗi luồng.
Thứ hai — phải có cột đánh dấu. Không có nó, mỗi lần chạy lại là quét lại đúng những website đã chết, tốn hàng giờ vô ích. Một cột DateTime? nhỏ giải quyết cả vấn đề.
Thứ ba — một tham số nhỏ làm mất nửa sản lượng. Giảm từ 3 trang liên hệ xuống 2 và timeout từ 20 giây xuống 12 giây làm tỷ lệ tìm được email tụt từ 41% xuống 18%. Khi làm dữ liệu, độ phủ nguồn quan trọng hơn tốc độ.
6. Vận hành: thứ quyết định hệ thống sống hay chết
- Deploy: dừng scheduled task → dừng tiến trình →
dotnet publishra thư mục chạy → bật lại → chờ endpoint/readytrả 200. Không có bước nào bị bỏ qua, vì bỏ qua là downtime. - Migration: chạy tự động khi khởi động, có cơ chế thử lại mỗi 30 giây nếu database chưa sẵn sàng.
- Health check tách hai mức:
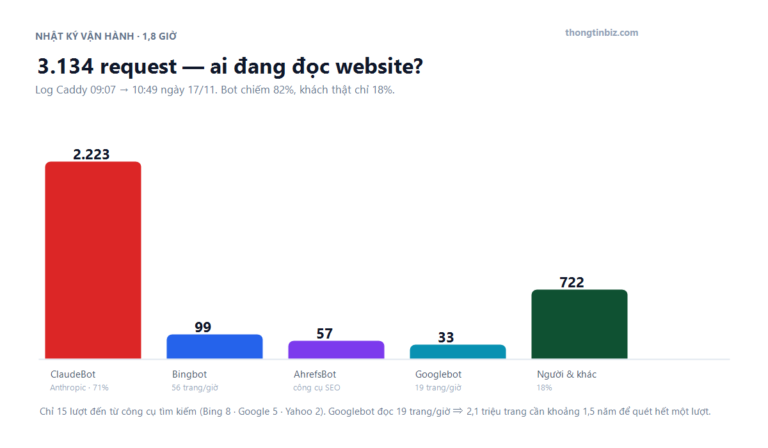
/healthcho biết tiến trình còn sống,/readycho biết database đã kết nối — vì “sống” mà không đọc được database thì vẫn là chết với người dùng. - Log: access log JSON của Caddy là nguồn phân tích thật (ai đọc gì, bot nào, bao nhiêu). Không có log thì mọi tranh luận về hiệu năng và bảo mật chỉ là cảm tính.
- Backup database theo lịch, và đã từng có lần phải dùng đến.
7. Những gì chúng tôi cố tình KHÔNG làm
Phần này quan trọng ngang phần đã làm. Với mỗi lựa chọn kiến trúc, cái bị loại bỏ cũng đáng được ghi lại:
- Không microservice. Một tiến trình web + một CLI crawler là đủ. Chia nhỏ thành 6 service chỉ làm tăng số chỗ có thể hỏng, tăng chi phí vận hành, và không giải quyết bài toán nào thật sự tồn tại ở quy mô này.
- Không SPA cho phần nội dung. HTML render phía máy chủ giúp công cụ tìm kiếm đọc được ngay, và người dùng trên mạng 3G vẫn thấy nội dung chỉ sau một request.
- Không cache phân tán. Redis rất hay, nhưng khi chỉ có một máy chủ thì bộ nhớ trong tiến trình là đủ và nhanh hơn hẳn. Thêm Redis lúc này chỉ thêm một điểm có thể chết.
- Không dùng ORM cho truy vấn nặng. Các câu đếm và lọc lớn được viết SQL rõ ràng để kiểm soát chỉ mục. ORM dùng cho thao tác ghi và truy vấn đơn giản — đúng chỗ của nó.
- Không lưu ảnh và file trong database. File Excel sinh ra nằm trên đĩa, database chỉ giữ đường dẫn và token. Sao lưu database vì thế nhẹ và nhanh.
- Không hứa “realtime”. Dữ liệu đăng ký kinh doanh thay đổi theo ngày, không theo giây. Hứa realtime là tự tạo kỳ vọng không đáp ứng được.
Bài học: kiến trúc tốt là kiến trúc giải thích được từng khối và từng chỗ đã loại bỏ. Nếu bạn không nói được vì sao mình KHÔNG dùng một công nghệ, rất có thể bạn đang dùng nó vì nó phổ biến chứ không vì nó cần thiết.
8. Năm bài học backend rút ra từ chính hệ thống này
1. Đừng tin thứ người khác tự khai (User-Agent, header, tham số). Hãy xác minh bằng nguồn độc lập.
2. Không có cột đánh dấu trạng thái thì mọi job nền sẽ chạy lại vô hạn.
3. Đặt hạn mức theo đơn vị mà kẻ tấn công không đổi được (subnet), không theo thứ họ đổi được (IP đơn lẻ).
4. Tính toán nặng phải ra khỏi request: tính theo lô, lưu kết quả, đọc khi cần.
5. Mọi thứ không đo được thì không quản được — kể cả “chất lượng dữ liệu”.
PHẦN 3 — Học Backend: lộ trình 90 ngày và khoá học liên quan
1. Vì sao người làm dữ liệu nên học backend
Bạn có thể phân tích dữ liệu giỏi bằng pandas, nhưng có ba việc chỉ backend làm được:
- Đưa kết quả phân tích đến người dùng: một mô hình hay nằm trong notebook thì không ai dùng. Đóng gói thành API/website mới có giá trị.
- Tự động hoá thu thập dữ liệu: cron job, crawler, xử lý lỗi, chạy lại — đó là backend, không phải phân tích.
- Kiểm soát ai được xem gì: che số, phân quyền, tính credit, chống cào. Không có lớp này thì dữ liệu của bạn là của công cộng.
Nói cách khác: data analyst làm ra insight, backend engineer làm ra sản phẩm từ insight đó. Người làm được cả hai là người tự dựng được công ty dữ liệu nhỏ — như thongtinbiz.com.
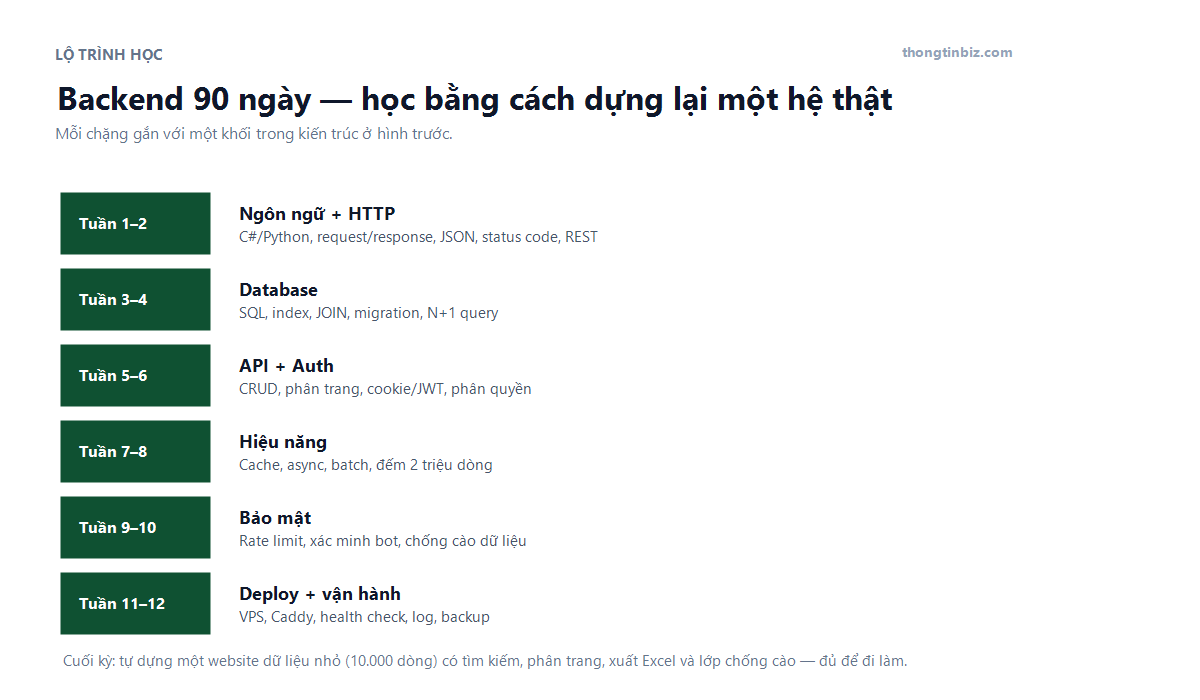
2. Lộ trình 90 ngày
| Chặng | Nội dung | Sản phẩm cuối chặng |
|---|---|---|
| Tuần 1–2 | Ngôn ngữ, HTTP, JSON, REST, status code | API trả JSON 3 endpoint |
| Tuần 3–4 | SQL, index, JOIN, migration, tránh N+1 | Database 100.000 dòng có tìm kiếm, phân trang |
| Tuần 5–6 | Auth (cookie/JWT), phân quyền, validate dữ liệu | Đăng ký/đăng nhập, 2 mức quyền |
| Tuần 7–8 | Cache, async, xử lý theo lô, đo thời gian phản hồi | Trang chủ < 300ms với 1 triệu dòng |
| Tuần 9–10 | Rate limit, xác minh bot, chống cào, honeypot | Chặn được curl -A Googlebot |
| Tuần 11–12 | VPS, reverse proxy, health check, log, backup | Hệ thống chạy thật trên tên miền riêng |
3. Khoá học Backend tại Hướng Nghiệp Dữ Liệu
Lộ trình trên được dạy trong các khoá sau — chọn theo ngôn ngữ bạn muốn đi sâu:
- Khoá .NET Backend — đúng stack của thongtinbiz.com: ASP.NET Core, EF Core, Razor Pages, PostgreSQL/SQL Server, deploy VPS. Phù hợp nếu bạn muốn dựng website dữ liệu hoặc hệ thống nội bộ cho doanh nghiệp.
- Khoá Backend NodeJS & FastAPI — hướng phổ biến cho người học nhanh, dễ xin việc ở các công ty outsource và startup.
- Build Backend API hoàn chỉnh — từ Python nâng cao đến triển khai thực chiến, đi thẳng vào việc làm sản phẩm.
- Backend FastAPI cho bot auto trading — dành cho ai làm fintech/trading, nơi yêu cầu về độ trễ và bảo mật khắt khe nhất.
- Fullstack là gì — để hiểu mình nên dừng ở backend hay đi tiếp lên giao diện.
Và các bài nền tảng nên đọc trước khi học:
- API là gì và cơ chế kết nối dữ liệu
- Backend là gì
- Nối API từ phía giao diện (Flutter)
- Deploy lên VPS — bước cuối nhưng ít người dạy kỹ
4. Năm bài tập thực hành bám theo thongtinbiz.com
Học backend mà không làm dự án thật thì rất nhanh quên. Đây là 5 bài tập tăng dần, mỗi bài đều có sản phẩm kiểm chứng được:
- Thu thập công khai: đọc 200 website trong một lĩnh vực, bóc email và số di động, lưu ra CSV. Đo tỷ lệ trúng — bạn sẽ thấy 20–40% là con số thật tế.
- Nhập liệu an toàn: nạp CSV đó vào PostgreSQL, thiết kế schema chống trùng theo khoá tự nhiên, viết migration thay vì sửa tay.
- Tìm kiếm + phân trang: dựng trang danh sách có lọc theo tỉnh/ngành/khoá tìm kiếm, đếm tổng dòng, và phải dưới 300ms khi có 100.000 dòng.
- Xuất Excel có bảo vệ: thêm đăng nhập, tính credit, sinh file bằng ClosedXML, cấp token tải dùng một lần.
- Chống cào: thử tự tấn công hệ thống của mình bằng
curlvới UA giả; sau đó thêm rate limit theo /24 và xác minh bot bằng DNS. Mục tiêu: 0/60 request lọt.
Làm xong 5 bài này, bạn có trong tay một sản phẩm nhỏ nhưng đầy đủ vòng đời: thu thập → lưu trữ → phục vụ → kiếm tiền → phòng thủ. Đó chính là toàn bộ câu chuyện của thongtinbiz.com, chỉ thu nhỏ lại 200 lần.
Kết
thongtinbiz.com về bản chất là một câu trả lời cho câu hỏi rất cũ: làm sao biến dữ liệu công khai thành thứ có người trả tiền? Câu trả lời có ba phần — phần dịch vụ (tra cứu, Excel, gói data, làm giàu dữ liệu), phần backend (6 khối, hiệu năng, bảo mật, vận hành) và phần con người (người biết cả phân tích dữ liệu lẫn kỹ thuật để dựng sản phẩm).
Nếu bạn muốn đi con đường đó, đừng bắt đầu bằng framework. Hãy bắt đầu bằng một tập dữ liệu thật, một trang tìm kiếm thật, và một người dùng thật. Mọi thứ còn lại — cache, rate limit, xác minh bot, pipeline làm giàu — chỉ là hệ quả của việc có người dùng thật.
🚀 Bắt đầu từ đâu?
• Dùng thử dữ liệu: thongtinbiz.com — tra cứu miễn phí 2,1 triệu hồ sơ doanh nghiệp
• Học backend để tự dựng hệ thống: Khoá .NET Backend · NodeJS & FastAPI
• Cần tư vấn lộ trình: Hotline/Zalo 0927 909 582
Bài viết liên quan