Sự cố cạn 100 kết nối PostgreSQL: phân tích 7 phút sập web và cách sửa
Mục lục bài viết
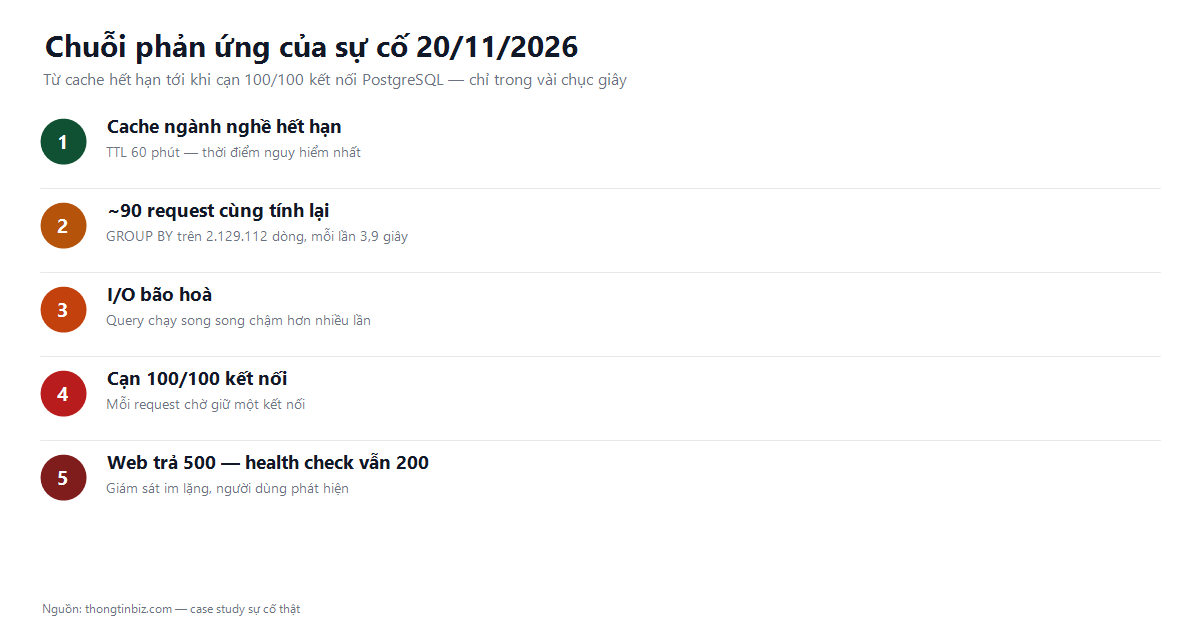
Ngày 20/11/2026, thongtinbiz.com chết trong khoảng 7 phút. Trang chủ trả lỗi 500, ô tìm kiếm không phản hồi, kể cả công cụ quản trị cơ sở dữ liệu cũng không đăng nhập được. Điều đáng nói: health check vẫn báo 200 — hệ thống giám sát hoàn toàn không biết site đã chết.
Bài này kể lại toàn bộ sự việc: cách phát hiện, cách khoanh vùng trong 6 bước, nguyên nhân gốc (cache stampede làm cạn 100/100 kết nối PostgreSQL), ba lớp phòng thủ đã thêm vào code, và cách kiểm chứng bằng tải thật. Cuối bài là danh sách kỹ năng backend cần có để tự xử lý tình huống tương tự mà không phải đoán.
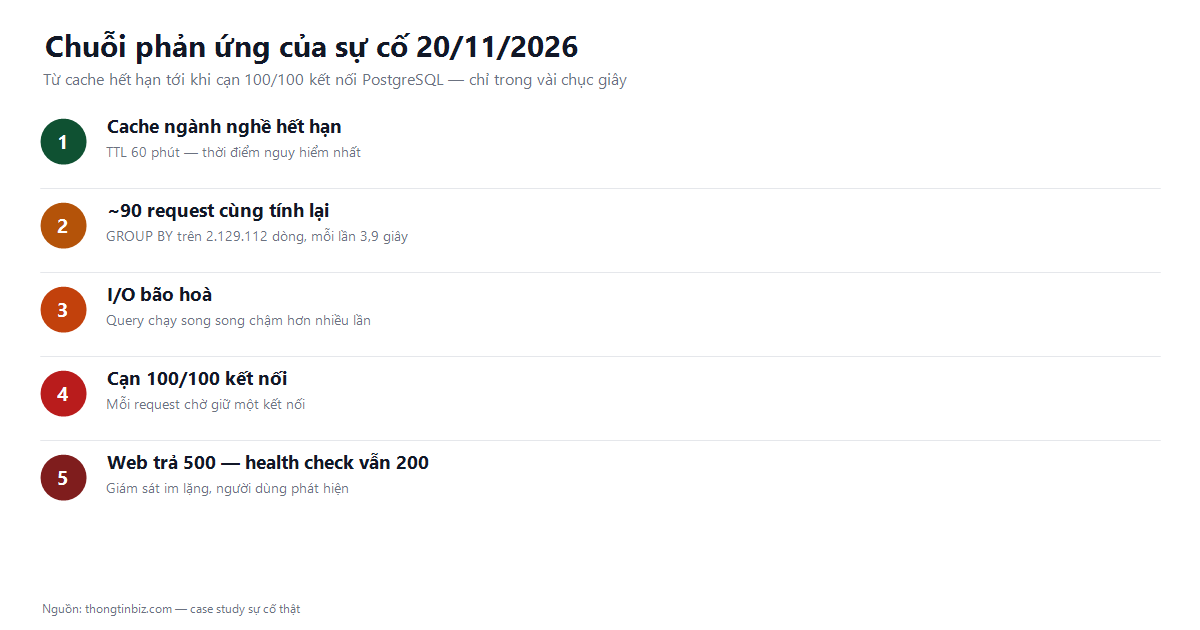
• Triệu chứng: mọi trang dùng DB trả 500, riêng
/ready vẫn 200 → giám sát báo “site sống”.• Nguyên nhân: ~90 request đồng thời cùng chạy một query
GROUP BY trên 2,1 triệu dòng → cạn 100/100 kết nối PostgreSQL.• Bản chất: cache stampede — cache hết hạn/restart thì mọi request cùng thấy “chưa có dữ liệu” và cùng đi tính lại.
• Cách sửa: khoá
SemaphoreSlim cho 2 facet nặng + giới hạn pool kết nối về 40.• Kiểm chứng: 25 request đồng thời lúc cache nguội → 25/25 thành công, trung vị 422 ms, đỉnh chỉ 16 kết nối DB.
Diễn biến: 7 phút từ “vẫn chạy” tới “không vào được”
| Thời điểm | Việc xảy ra | Trạng thái |
|---|---|---|
| 10:41 | Người dùng báo “web không vào được” | Chưa rõ nguyên nhân |
| 10:41 | Kiểm tra tiến trình: web vẫn sống, cổng nội bộ vẫn mở, Caddy vẫn chạy | Hạ tầng “bình thường” |
| 10:42 | Gọi thử 4 địa chỉ: /ready = 200 sau 115 ms; / = 500 sau 6,2 giây |
Mâu thuẫn |
| 10:43 | Quét 13 đường dẫn: chỉ /ready và trang đăng nhập quản trị (không chạm DB) là 200. Toàn bộ trang có dữ liệu: 500 hoặc treo vô hạn |
Khoanh vùng: DB |
| 10:43 | Đếm kết nối PostgreSQL: 101 kết nối, 101 đều “active”. max_connections = 100 |
Tìm ra thủ phạm |
| 10:44 | Đọc danh sách query đang chạy: ~90 query giống hệt nhau, tất cả là GROUP BY trên bảng 2,1 triệu dòng |
Xác định nguyên nhân |
| 10:45 | Dừng web để nhả kết nối, khởi động lại | Kết nối vẫn bị giữ |
| 10:47 | Khởi động lại PostgreSQL (fast shutdown) để xoá toàn bộ phiên treo | Sạch kết nối |
| 10:48 | Làm ấm cache bằng request đơn, kiểm tra lại từng trang | Site trở lại |
Điểm cần nhớ: cái chết thật không phải là code hỏng, mà là tài nguyên cạn. Mã nguồn vẫn đúng, dữ liệu vẫn nguyên, tiến trình vẫn chạy — chỉ có 100/100 “chỗ ngồi” trong cơ sở dữ liệu bị chiếm bởi những query không ai cần chạy.
Vì sao health check báo 200 trong khi site đã chết
Đây là bài học đầu tiên và cũng là bài học đắt nhất.
Endpoint /ready của Thông Tin Biz được viết để trả lời câu hỏi “tiến trình đã khởi động xong chưa?” — chứ không phải “tiến trình còn phục vụ được không?”. Nó kiểm tra vài cờ trong bộ nhớ rồi trả 200. Khi DB cạn kết nối, những cờ đó vẫn đúng, nên health check vẫn xanh.
| Loại kiểm tra | Câu hỏi nó trả lời | Kết quả lúc sự cố |
|---|---|---|
Liveness (/ready hiện tại) |
Tiến trình còn sống không? | 200 — trả lời đúng nhưng vô dụng |
| Readiness thật | Có phục vụ được request thật không? | Phải là 503 |
| Dependency check | DB có nhận kết nối mới trong dưới 1 giây không? | Phải là 503 |
Nếu health check có kiểm tra DB, hệ thống giám sát đã báo động ngay từ request đầu tiên thay vì để người dùng phát hiện. Đây là việc cần sửa tiếp theo — và là ví dụ rõ cho câu “monitoring không đúng thì monitoring còn tệ hơn không có”.
Chẩn đoán trong 6 bước: đo từ ngoài vào trong
Khi site chết, phản xạ thường là đọc log. Nhưng log chỉ hữu ích khi bạn đã biết tìm ở đâu. Thứ tự đúng là đo từ ngoài vào trong — mỗi bước loại bỏ một tầng, và dừng lại ở tầng đầu tiên có bất thường.
| Bước | Đo gì | Kết quả sự cố này | Kết luận |
|---|---|---|---|
| 1 | HTTP từ ngoài vào domain | 500 | Lỗi ở tầng ứng dụng/DB, không phải mạng |
| 2 | Tiến trình và cổng | Web sống, cổng mở | Không phải crash |
| 3 | Gọi trực tiếp cổng nội bộ (bỏ qua proxy) | Vẫn 500 | Không phải lỗi Caddy/reverse proxy |
| 4 | Trang không chạm DB | 200 | Ứng dụng còn chạy; lỗi nằm ở truy cập dữ liệu |
| 5 | Số kết nối DB và trạng thái | 101/100, toàn bộ active |
Cạn pool kết nối |
| 6 | Nội dung query đang chạy | ~90 query giống nhau | Stampede |
Bước 4 là bước quyết định. Chỉ cần một đường dẫn không dùng cơ sở dữ liệu mà vẫn trả 200 là đủ để loại bỏ toàn bộ giả thuyết về mạng, DNS, chứng chỉ, reverse proxy. Từ đó chỉ còn một hướng để đào.
Nguyên nhân gốc: cache stampede
Thông Tin Biz có một truy vấn tổng hợp dùng để dựng danh mục ngành nghề:
SELECT "IndustrySlug", "IndustryName", count(*) AS "Count"
FROM "Companies"
WHERE "IndustrySlug" IS NOT NULL AND "IndustryName" IS NOT NULL
GROUP BY "IndustrySlug", "IndustryName"
ORDER BY 3 DESC;
Đo thực tế trên 2.129.112 dòng:
| Chỉ số | Giá trị đo được | Ý nghĩa |
|---|---|---|
| Thời gian chạy | 3,9 giây | Chậm gấp ~40 lần một query thường |
| Cách Postgres chạy | Parallel Seq Scan (3 tiến trình) | Không dùng được index vì 86% số dòng đều khớp điều kiện |
| Đọc từ đĩa/bộ đệm | 169.710 buffer | Quét gần như toàn bảng |
| Sắp xếp tạm | 56 MB mỗi tiến trình, ghi ra đĩa | Tốn I/O gấp đôi |
| Kết quả trả về | 2.872 nhóm ngành | Dữ liệu nhỏ, chi phí nằm ở phần tính |
Vì nặng như vậy, kết quả được cache 60 phút trong bộ nhớ. Vấn đề nằm ở đoạn code cache:
// Cách viết SAI (trước sự cố)
if (_cache.TryGetValue(CacheIndustries, out IReadOnlyList<FacetItem>? cached) && cached is not null)
    return cached;

// Cache rỗng → mọi request đều chạy tới đây và tự đi tính lại
var rows = await _db.Companies.AsNoTracking() ... .ToListAsync(ct);
_cache.Set(CacheIndustries, result, FacetTtlLong);
Đoạn code này đúng khi chỉ có một request. Khi có N request đồng thời và cache đang rỗng, cả N request đều lọt qua điều kiện TryGetValue và cùng chạy query. Hiện tượng này gọi là cache stampede (hay “thundering herd”).
Trong sự cố này N ≈ 90. Mỗi query 3,9 giây, chạy song song trên cùng một ổ đĩa, tất cả cùng chờ I/O — nên thời gian thực tế tăng lên hàng chục giây. Mỗi request đang chờ giữ một kết nối. 90 request = 90 kết nối. Cộng với vài chục request khác đang chờ theo → 100/100 slot bị chiếm.
Từ đó hình thành vòng xoáy chết:
90 query nặng đồng thời
   → I/O bão hoà, mỗi query chậm hơn
      → mỗi request giữ kết nối lâu hơn
         → pool cạn (100/100)
            → request mới không lấy được kết nối → 500
               → người dùng tải lại → thêm request
                  → càng cạn
Điều đáng chú ý: đây KHÔNG phải lỗi của bản deploy mới
Trong lúc sự cố rất dễ kết luận “vừa deploy xong nên deploy làm hỏng”. Nhưng bằng chứng nói khác:
| Bằng chứng | Số liệu |
|---|---|
| Bản deploy mới chạy từ | 10:30:29 |
| Bản deploy mới phục vụ bình thường | hơn 10 phút, nhiều trang trả 200 bình thường |
| Query nặng đầu tiên xuất hiện | 10:43:50 — sau 13 phút |
| Mã nguồn liên quan có bị sửa không? | Không. Đoạn cache này giữ nguyên |
Nguyên nhân thật là cache hết hạn. Cache 60 phút, hệ thống chạy liên tục nhiều giờ, và tới một thời điểm cache ngành nghề hết hạn. Nếu lúc đó chỉ có 1 người truy cập thì không sao. Nếu lúc đó có một đợt truy cập đồng thời (bot quét, người dùng, hoặc chỉ vài tab mở cùng lúc) thì bùng nổ.
Nói cách khác: lỗi đã nằm trong hệ thống từ lâu, chỉ chờ đúng thời điểm để phát nổ. Deploy chỉ là trùng hợp về thời gian. Phân biệt được hai chuyện này là khác biệt giữa “rollback rồi chờ nó xảy ra lại” và “sửa được gốc”.
Ba lớp phòng thủ đã thêm vào
Lớp 1 — Khoá chỉ cho một query nặng chạy
Ý tưởng: request đầu tiên đi tính, các request sau chờ rồi đọc kết quả đã cache. Trong C# dùng SemaphoreSlim:
// Phải là static: service là scoped (mỗi request một instance),
// nếu để instance thì mỗi request một khoá → hoàn toàn vô dụng.
private static readonly SemaphoreSlim FacetFillLock = new(1, 1);

private async Task<IReadOnlyList<FacetItem>> LoadIndustriesAsync(CancellationToken ct)
{
    if (_cache.TryGetValue(CacheIndustries, out IReadOnlyList<FacetItem>? cached) && cached is not null)
        return cached;

    await FacetFillLock.WaitAsync(ct);
    try
    {
        // Kiểm tra LẦN HAI sau khi lấy được khoá:
        // trong lúc chờ, request khác có thể đã tính xong và ghi cache.
        if (_cache.TryGetValue(CacheIndustries, out cached) && cached is not null)
            return cached;

        var rows = await _db.Companies.AsNoTracking()
            .Where(c => c.IndustrySlug != null && c.IndustryName != null)
            .GroupBy(c => new { c.IndustrySlug, c.IndustryName })
            .Select(g => new { Slug = g.Key.IndustrySlug!, Name = g.Key.IndustryName!, Count = g.Count() })
            .OrderByDescending(x => x.Count)
            .ToListAsync(ct);

        IReadOnlyList<FacetItem> result = rows.Select(r => new FacetItem(r.Slug, r.Name, r.Count)).ToList();
        _cache.Set(CacheIndustries, result, FacetTtlLong);
        return result;
    }
    finally
    {
        FacetFillLock.Release();
    }
}
Ba chi tiết dễ làm sai:
| Chi tiết | Nếu làm sai |
|---|---|
Khoá phải static |
Mỗi request một khoá → không chặn được gì, stampede vẫn xảy ra |
| Phải kiểm tra cache lần hai sau khi lấy khoá | Request thứ 2 vào sau khi request 1 đã tính xong vẫn chạy lại query |
Phải Release() trong finally |
Một exception làm khoá bị giữ vĩnh viễn → mọi request sau treo |
Lớp 2 — Giới hạn số kết nối của ứng dụng
Lỗi thiết kế táo bạo nhất của hệ thống cũ: pool kết nối mặc định (100) đúng bằng max_connections của PostgreSQL (100). Nghĩa là ứng dụng có thể chiếm sạch, không chừa một slot nào cho quản trị, backup hay một tiến trình khác.
static string BuildNpgsqlConnectionString(string connectionString)
{
    try
    {
        var b = new Npgsql.NpgsqlConnectionStringBuilder(connectionString);
        if (b.MaxPoolSize <= 0 || b.MaxPoolSize > 40) b.MaxPoolSize = 40;
        if (b.Timeout <= 0 || b.Timeout > 15) b.Timeout = 15;
        return b.ConnectionString;
    }
    catch
    {
        return connectionString;
    }
}
Chọn 40 vì: dưới tải bình thường site chỉ cần 4–16 kết nối; 40 là dư cho đỉnh cao; và còn 60 slot cho psql, tiến trình crawl dữ liệu và API. Điều quan trọng hơn cả con số: khi ứng dụng hết pool, nó xếp hàng thay vì giết cả cơ sở dữ liệu. Hết pool là lỗi cục bộ của ứng dụng, cạn slot của Postgres là lỗi toàn hệ thống.
Lớp 3 — Timeout để fail nhanh
Đã có CommandTimeout(60); bổ sung Timeout=15 cho việc mở kết nối. Nguyên tắc: thà trả lỗi sau 15 giây còn hơn treo 3 phút. Một request treo không chỉ làm chậm chính nó — nó còn giữ kết nối, và kết nối là tài nguyên dùng chung.
Bốn cách làm mới cache — và cách nào phù hợp
Khoá SemaphoreSlim chỉ là cách đơn giản nhất. Có bốn chiến lược làm mới cache, mỗi cách đánh đổi khác nhau:
| Cách | Cơ chế | Ưu điểm | Nhược điểm | Dùng khi |
|---|---|---|---|---|
| 1. Khoá (đã dùng) | Một request được tính, số còn lại chờ | Đơn giản, không cần thêm hạ tầng | Người chờ đầu tiên phải đợi đủ lâu bằng một lần tính | Một máy chủ, dữ liệu không cần tức thời |
| 2. Làm mới nền | Trước khi hết hạn, một tác vụ nền tính lại | Người dùng không bao giờ phải chờ | Cần thêm tác vụ nền; dữ liệu vẫn cũ trong một khoảng | Dữ liệu biết trước chu kỳ cập nhật |
| 3. Trả dữ liệu cũ | Hết hạn nhưng vẫn trả bản cũ, đồng thời tính bản mới | Không ai phải chờ, không có khoảng trống | Phức tạp hơn; phải chấp nhận dữ liệu trễ | Bảng danh mục, số liệu tổng hợp |
| 4. Tính sẵn trong DB | Bảng tổng hợp/materialized view, làm mới theo lịch | Query đọc gần như tức thì | Phải quản lý việc làm mới; thêm một chỗ có thể lệch | Dữ liệu lớn, đọc rất nhiều |
Với Thông Tin Biz, cách 1 đã đủ để chặn sự cố. Nhưng về dài hạn, cách 4 là hướng đúng cho facet ngành nghề: bảng chỉ có 2.872 dòng kết quả, hoàn toàn có thể tính sẵn mỗi giờ một lần, còn truy vấn đọc chỉ là SELECT trên 2.872 dòng nên gần như tức thì. Kết hợp 1 và 4 sẽ biến query 3,9 giây thành query không đáng kể.
Một chi tiết dễ bỏ sót ở cách 1: thời gian chờ của người dùng tỷ lệ với thời gian tính. Nếu query mất 3,9 giây thì người vào đầu tiên chờ 3,9 giây — chấp nhận được. Nhưng nếu có ngày dữ liệu tăng gấp đôi và query mất 10 giây thì lại phải xem lại. Đây là lý do vẫn nên theo dõi thời gian của query này theo thời gian, thay vì coi như đã xong.
Kiểm chứng: bắn 25 request đồng thời lúc cache nguội
Sửa xong mà không đo thì chỉ là tin vào lý thuyết. Cách kiểm chứng đúng là tái tạo đúng điều kiện gây lỗi: cache phải nguội (chuyển sang slot mới = bộ nhớ đệm rỗng) rồi bắn nhiều request cùng lúc.
| Kịch bản | Kết quả |
|---|---|
| Trước khi sửa — nhiều request cùng lúc lúc cache nguội | Cạn 100/100 kết nối, site chết, psql không vào được |
| Sau khi sửa — 25 request đồng thời vào trang nặng, cache nguội | 25/25 trả 200 · trung vị 422 ms · chậm nhất 576 ms |
| Đỉnh kết nối DB trong lúc bắn tải | 16 / 100 |
| 20 request đồng thời vào trang chủ | 20/20 trả 200 · trung vị 398 ms |
| 12 trang chính sau sự cố | 12/12 trả 200 |
Điểm mấu chốt không phải “nhanh hơn”, mà là tải tăng 25 lần thì số kết nối DB không tăng 25 lần. Đó chính là tác dụng của khoá: chỉ một query nặng chạy, 24 request còn lại chờ vài trăm mili giây để đọc kết quả dùng chung.
Bảy bài học rút ra
| # | Bài học | Áp dụng cụ thể |
|---|---|---|
| 1 | Health check phải chạm phụ thuộc thật | Readiness nên kiểm DB bằng một query rẻ (SELECT 1) với timeout 1 giây |
| 2 | Cache thiếu khoá là bom hẹn giờ | Mọi chỗ TryGetValue + query nặng đều cần khoá hoặc single-flight |
| 3 | Pool ứng dụng phải nhỏ hơn max_connections | Để lại ít nhất 40% slot cho quản trị, backup, tiến trình phụ |
| 4 | Đo từ ngoài vào trong, đừng đọc log trước | 6 bước ở trên; bước “trang không chạm DB” chia đôi không gian tìm kiếm |
| 5 | Đừng đổ lỗi cho deploy mới nhất | So mốc thời gian: deploy 10:30 vs query nặng 10:43, và kiểm tra file có bị sửa không |
| 6 | Cache 60 phút không có nghĩa là an toàn 60 phút | Điểm nguy hiểm nhất là đúng lúc cache hết hạn, không phải lúc deploy |
| 7 | Kiểm chứng bằng tải thật, không bằng “chạy được rồi” | Bắn 20–25 request đồng thời khi cache nguội — điều kiện gây lỗi phải được tái tạo |
Những gì CHƯA sửa xong (nợ kỹ thuật còn lại)
Viết case study mà chỉ kể phần đã sửa xong là thiếu trung thực. Đây là danh sách những việc còn lại, xếp theo mức ưu tiên:
| # | Việc cần làm | Vì sao quan trọng | Mức ưu tiên |
|---|---|---|---|
| 1 | Đổi readiness check sang kiểm tra DB thật | Không có nó thì lần sau vẫn không ai biết site đã chết | Cao nhất |
| 2 | Cảnh báo khi số kết nối DB vượt 70% | Phát hiện trước khi cạn, không phải sau khi cạn | Cao |
| 3 | Tính sẵn facet ngành nghề vào bảng tổng hợp | Biến query 3,9 giây thành dưới 1 ms | Trung bình |
| 4 | Đặt lịch crawl/import ngoài giờ cao điểm | Tiến trình nặng chạy cùng lúc cũng gây hiệu ứng tương tự | Trung bình |
| 5 | Ghi lại thời gian các query chậm để theo dõi xu hướng | Dữ liệu tăng thì query chậm dần — cần thấy trước | Thấp |
Điều đáng nói: mục 1 và 2 rẻ hơn nhiều so với thiệt hại của một lần sập. Nhưng chúng là loại việc không ai yêu cầu cho tới khi có sự cố — và đó là bản chất của nợ kỹ thuật trong vận hành.
Những kỹ năng backend thực sự dùng trong 7 phút đó
Điều đáng nói: trong toàn bộ sự cố không có một dòng nào liên quan tới giao diện. Tất cả đều là kỹ năng backend. Liệt kê ra thì thấy rõ khoảng cách giữa “biết viết API” và “vận hành được một hệ thống thật”:
| Kỹ năng | Dùng để làm gì trong sự cố này |
|---|---|
| Đọc trạng thái PostgreSQL | Biết đọc pg_stat_activity, phân biệt active / idle / idle in transaction |
| Đọc query plan | EXPLAIN (ANALYZE, BUFFERS) để thấy vì sao index không được dùng (86% selectivity) |
| Hiểu connection pool | Phân biệt “hết pool ứng dụng” và “cạn slot của database” — hai lỗi khác nhau, cách xử lý khác nhau |
| Quản lý tài nguyên trong code bất đồng bộ | SemaphoreSlim + finally + kiểm tra hai lần (double-check) |
| Thiết kế cache đúng | TTL, khoá, single-flight, và biết khi nào dữ liệu cache bị “nguội” |
| Giới hạn và timeout | Fail nhanh thay vì treo; bảo vệ tài nguyên dùng chung |
| Đo lường và kiểm chứng | Dựng lại điều kiện lỗi bằng tải đồng thời thay vì tin vào cảm giác |
Đây chính là nội dung của lộ trình học Backend 90 ngày — bài viết đó mô tả chính backend của thongtinbiz.com (2,1 triệu dòng, tìm kiếm, xuất Excel theo credit, phân quyền, thanh toán) nên có thể đọc song song với case study này để thấy lý thuyết và sự cố thật khớp nhau ở đâu.
Ba nhóm kiến thức cần học theo đúng thứ tự xuất hiện trong sự cố:
| Thứ tự | Kiến thức | Học ở đâu |
|---|---|---|
| 1 | Backend là gì, một request đi qua những tầng nào | Backend là gì? Toàn bộ cách hệ thống web vận hành phía sau |
| 2 | SQL và tối ưu câu lệnh — vì sao query 3,9 giây lại không dùng index | Tối ưu câu lệnh SELECT · SQL Server cơ bản |
| 3 | Xử lý lỗi, log và vận hành — đọc dấu hiệu hệ thống thay vì đoán | Bắt lỗi và log chi tiết |
| 4 | API, xác thực, bảo mật — nền tảng để làm backend nghiêm túc | 14 lỗ hổng bảo mật REST API thực tế |
| 5 | Làm sản phẩm hoàn chỉnh: API + mobile app + triển khai | Khoá Lập trình Mobile App Full Stack |
Checklist phòng ngừa cho hệ thống của bạn
Nếu bạn đang vận hành một website có cơ sở dữ liệu, hãy kiểm 8 điểm sau. Mỗi điểm tương ứng một lỗi đã gặp trong sự cố này:
| # | Kiểm tra | Cách kiểm trong 5 phút |
|---|---|---|
| 1 | Pool kết nối < max_connections |
Xem connection string và SHOW max_connections |
| 2 | Mọi query nặng có khoá chống stampede | Tìm các chỗ vừa TryGetValue vừa GROUP BY/COUNT |
| 3 | Health check chạm DB | Dừng DB thử → readiness phải trả 503, không phải 200 |
| 4 | Có timeout cho cả kết nối và câu lệnh | Đọc cấu hình; mặc định thường là vô hạn |
| 5 | Query chậm nhất được biết là query nào | pg_stat_statements sắp theo mean_exec_time |
| 6 | Có cảnh báo khi số kết nối vượt 70% | Giám sát pg_stat_activity |
| 7 | Không chạy tiến trình crawl/import nặng cùng lúc với giờ cao điểm | Đặt lịch ban đêm, hoặc giới hạn số luồng |
| 8 | Đã từng thử bắn 20+ request đồng thời chưa? | Nếu chưa: đó là bài kiểm tra rẻ nhất và hữu ích nhất |
Câu hỏi thường gặp
Cache stampede là gì?
Là hiện tượng nhiều request đồng thời cùng thấy cache rỗng nên cùng đi tính lại dữ liệu, biến một truy vấn nặng thành N truy vấn nặng chạy song song. Tên khác: thundering herd. Cách chống: khoá (chỉ một request được tính), hoặc làm mới cache nền trước khi hết hạn, hoặc trả dữ liệu cũ trong lúc tính lại.
Tại sao 100 kết nối lại hết nhanh như vậy?
Vì mỗi request đang xử lý giữ một kết nối suốt thời gian chờ. Khi 90 query nặng chạy song song làm I/O bão hoà, mỗi query chậm gấp nhiều lần bình thường, nên mỗi kết nối bị giữ lâu gấp nhiều lần. 100 kết nối không phải “nhiều” khi thời gian giữ tăng 10 lần.
Có nên tăng max_connections thay vì sửa code không?
Không. Tăng lên 500 chỉ làm sự cố khó xảy ra hơn một chút nhưng khi xảy ra sẽ nặng hơn: mỗi kết nối PostgreSQL là một tiến trình, ngốn RAM, và 500 query nặng chạy song song thì ổ đĩa còn chậm hơn nữa. Gốc là số query nặng chạy đồng thời, không phải số chỗ ngồi.
Vì sao PostgreSQL không dùng index có sẵn?
Vì 86% số dòng trong bảng thoả điều kiện. Khi tỷ lệ khớp quá cao, đọc tuần tự cả bảng còn rẻ hơn đọc index rồi nhảy vào bảng. Index chỉ thắng khi lọc ra một phần nhỏ dữ liệu.
Restart PostgreSQL có làm mất dữ liệu không?
Không, nếu dùng chế độ dừng an toàn (pg_ctl stop -m fast). PostgreSQL ghi log giao dịch (WAL) trước khi ghi dữ liệu, nên khi khởi động lại nó tự phục hồi về trạng thái nhất quán. Chỉ mất những giao dịch chưa kịp ghi log — điều gần như không xảy ra với fast shutdown.
Làm sao biết một query là “nặng”?
Quy tắc thực dụng: trên 1 giây là đáng chú ý, trên 3 giây là phải có chiến lược riêng (cache, tính trước, hoặc đổi cấu trúc dữ liệu). Đo bằng EXPLAIN (ANALYZE, BUFFERS) chứ không ước lượng bằng cảm giác.
Có cần dùng Redis để chống stampede không?
Không bắt buộc. Với một máy chủ, một khoá trong bộ nhớ (SemaphoreSlim) là đủ và rẻ hơn. Redis cần thiết khi chạy nhiều máy chủ (mỗi máy có cache riêng, khoá trong bộ nhớ không dùng chung được) — lúc đó cần khoá phân tán.
Sự cố này có ảnh hưởng dữ liệu khách hàng không?
Không. Sự cố là cạn tài nguyên kết nối, không phải hỏng hay mất dữ liệu. Không có giao dịch nào bị ghi dở; đơn hàng và credit không bị ảnh hưởng. Đây là điểm quan trọng để phân biệt “sập dịch vụ” với “mất dữ liệu” — hai mức độ hậu quả hoàn toàn khác nhau.
Bao lâu thì phát hiện ra nếu không có người dùng báo?
Trong trường hợp này: không biết. Health check trả 200 nên giám sát hoàn toàn im lặng. Đó là lý do việc sửa readiness check là ưu tiên số một sau sự cố — không có nó thì lần sau vẫn phụ thuộc vào việc có người tình cờ phát hiện.
Kết luận
Ba câu tóm gọn toàn bộ sự cố:
- Hệ thống chết vì tài nguyên, không vì code sai. Mã nguồn vẫn đúng — chỉ là nó cho phép 90 request cùng làm một việc nặng.
- Điểm chết người là chỗ giao nhau giữa cache và đồng thời. Cache đúng khi có một người dùng, sai khi có nhiều người dùng cùng lúc — và điều đó chỉ xảy ra ở đúng thời điểm cache hết hạn.
- Không đo thì không biết. Cả lúc phát hiện (health check nói dối) và lúc sửa (phải bắn 25 request đồng thời khi cache nguội) đều phụ thuộc vào việc đo đúng thứ.
Với người đang học backend, đây là lý do nên học vận hành chứ không chỉ học viết tính năng. Viết được API trả về đúng dữ liệu là mức cơ bản; biết vì sao nó sập khi có 25 người dùng cùng lúc mới là mức đi làm được. Lộ trình và các kỹ năng đó nằm trong bài về backend của thongtinbiz.com và lộ trình học BE 90 ngày.
Nếu bạn đang vận hành một hệ thống có cơ sở dữ liệu, việc nên làm ngay hôm nay không phải là đọc thêm về sự cố — mà là mở 8 mục trong checklist phòng ngừa ở trên và kiểm từng mục. Hầu hết hệ thống nhỏ đều sai ít nhất 3 mục, phổ biến nhất là pool kết nối bằng đúng max_connections và health check không chạm database.
Bài viết liên quan